
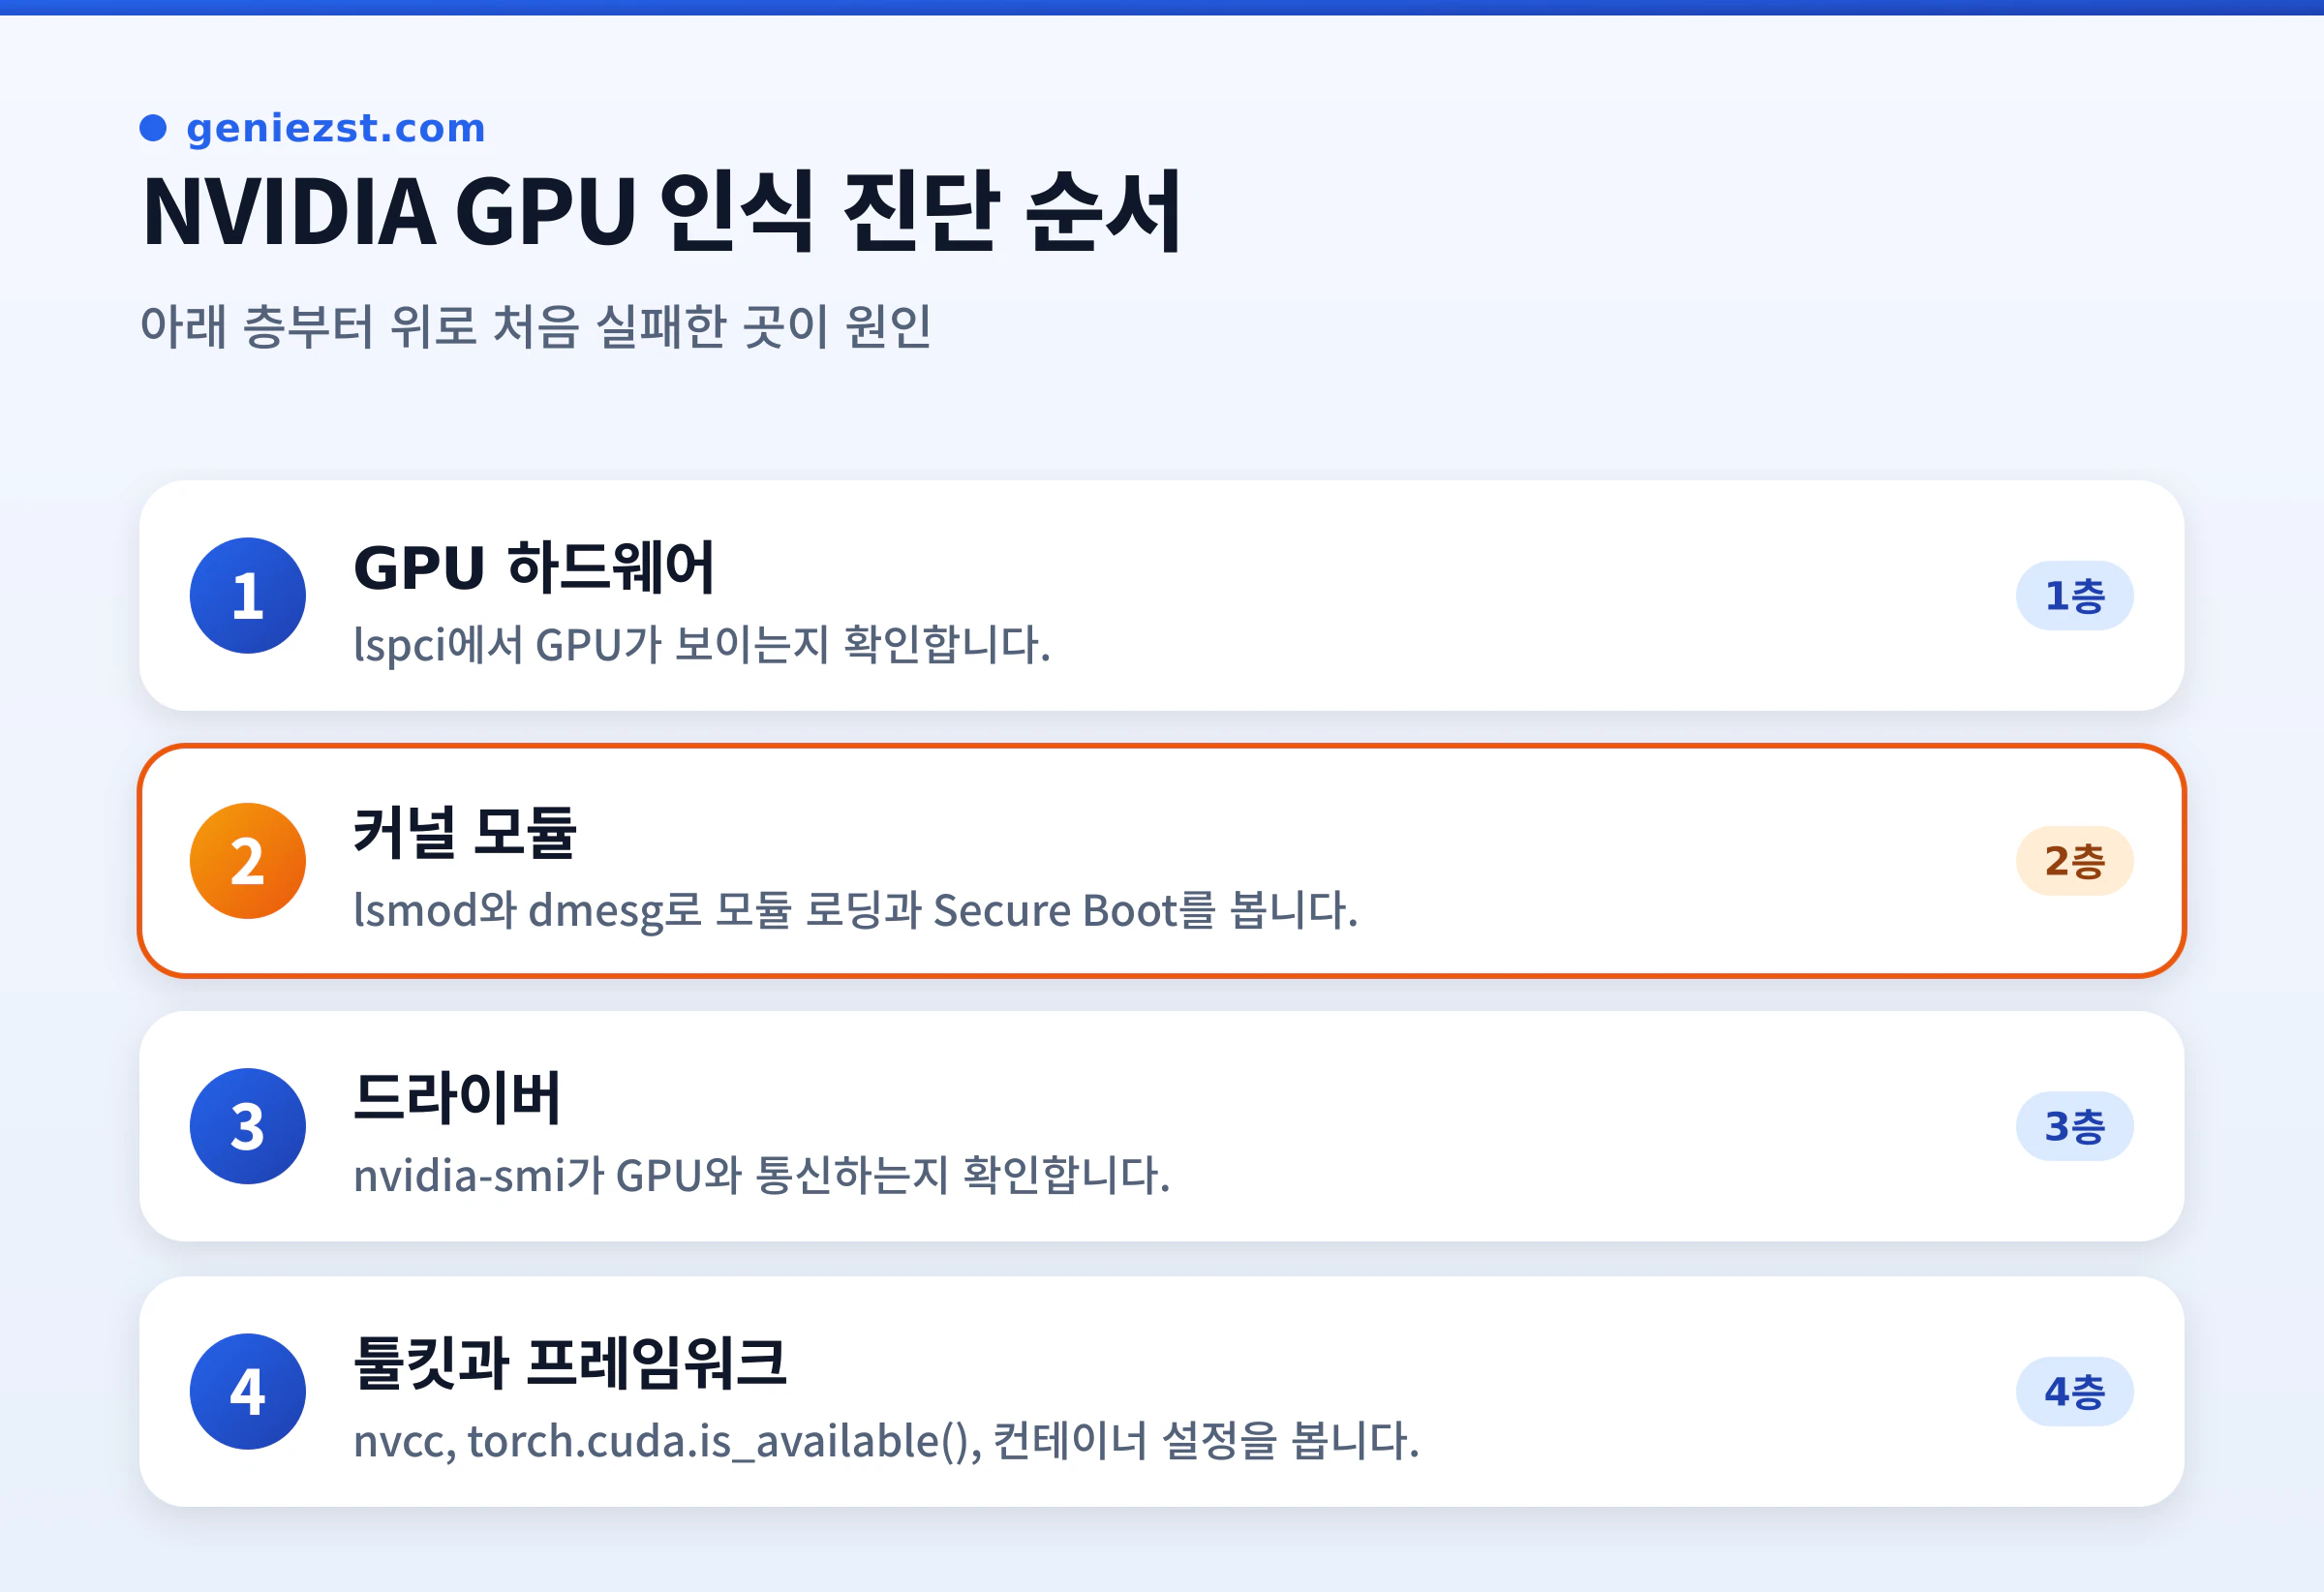
GPU를 쓰는 작업이 "CUDA를 찾을 수 없다"며 실패할 때는 문제가 어느 층에서 생겼는지부터 가려야 합니다. 층은 하드웨어 인식, 드라이버 커널 모듈, 사용자 공간 라이브러리, CUDA 툴킷, 그리고 그 위의 PyTorch나 Docker 순서로 쌓여 있고, 아래 층이 안 되면 위 층은 무엇을 해도 안 됩니다.
이 글은 명령어로 막힌 층을 찾는 순서와, 층마다 흔한 원인과 해결을 정리했습니다.
1단계 어느 층에서 막혔는지 확인
lspci | grep -i nvidia          # 1층 GPU가 PCI에서 보이는가
lsmod | grep nvidia             # 2층 커널 모듈이 올라왔는가
nvidia-smi                      # 3층 드라이버가 GPU와 통신하는가
nvcc --version                  # 4층 CUDA 툴킷이 설치됐는가
python3 -c "import torch; print(torch.cuda.is_available())"   # 5층 프레임워크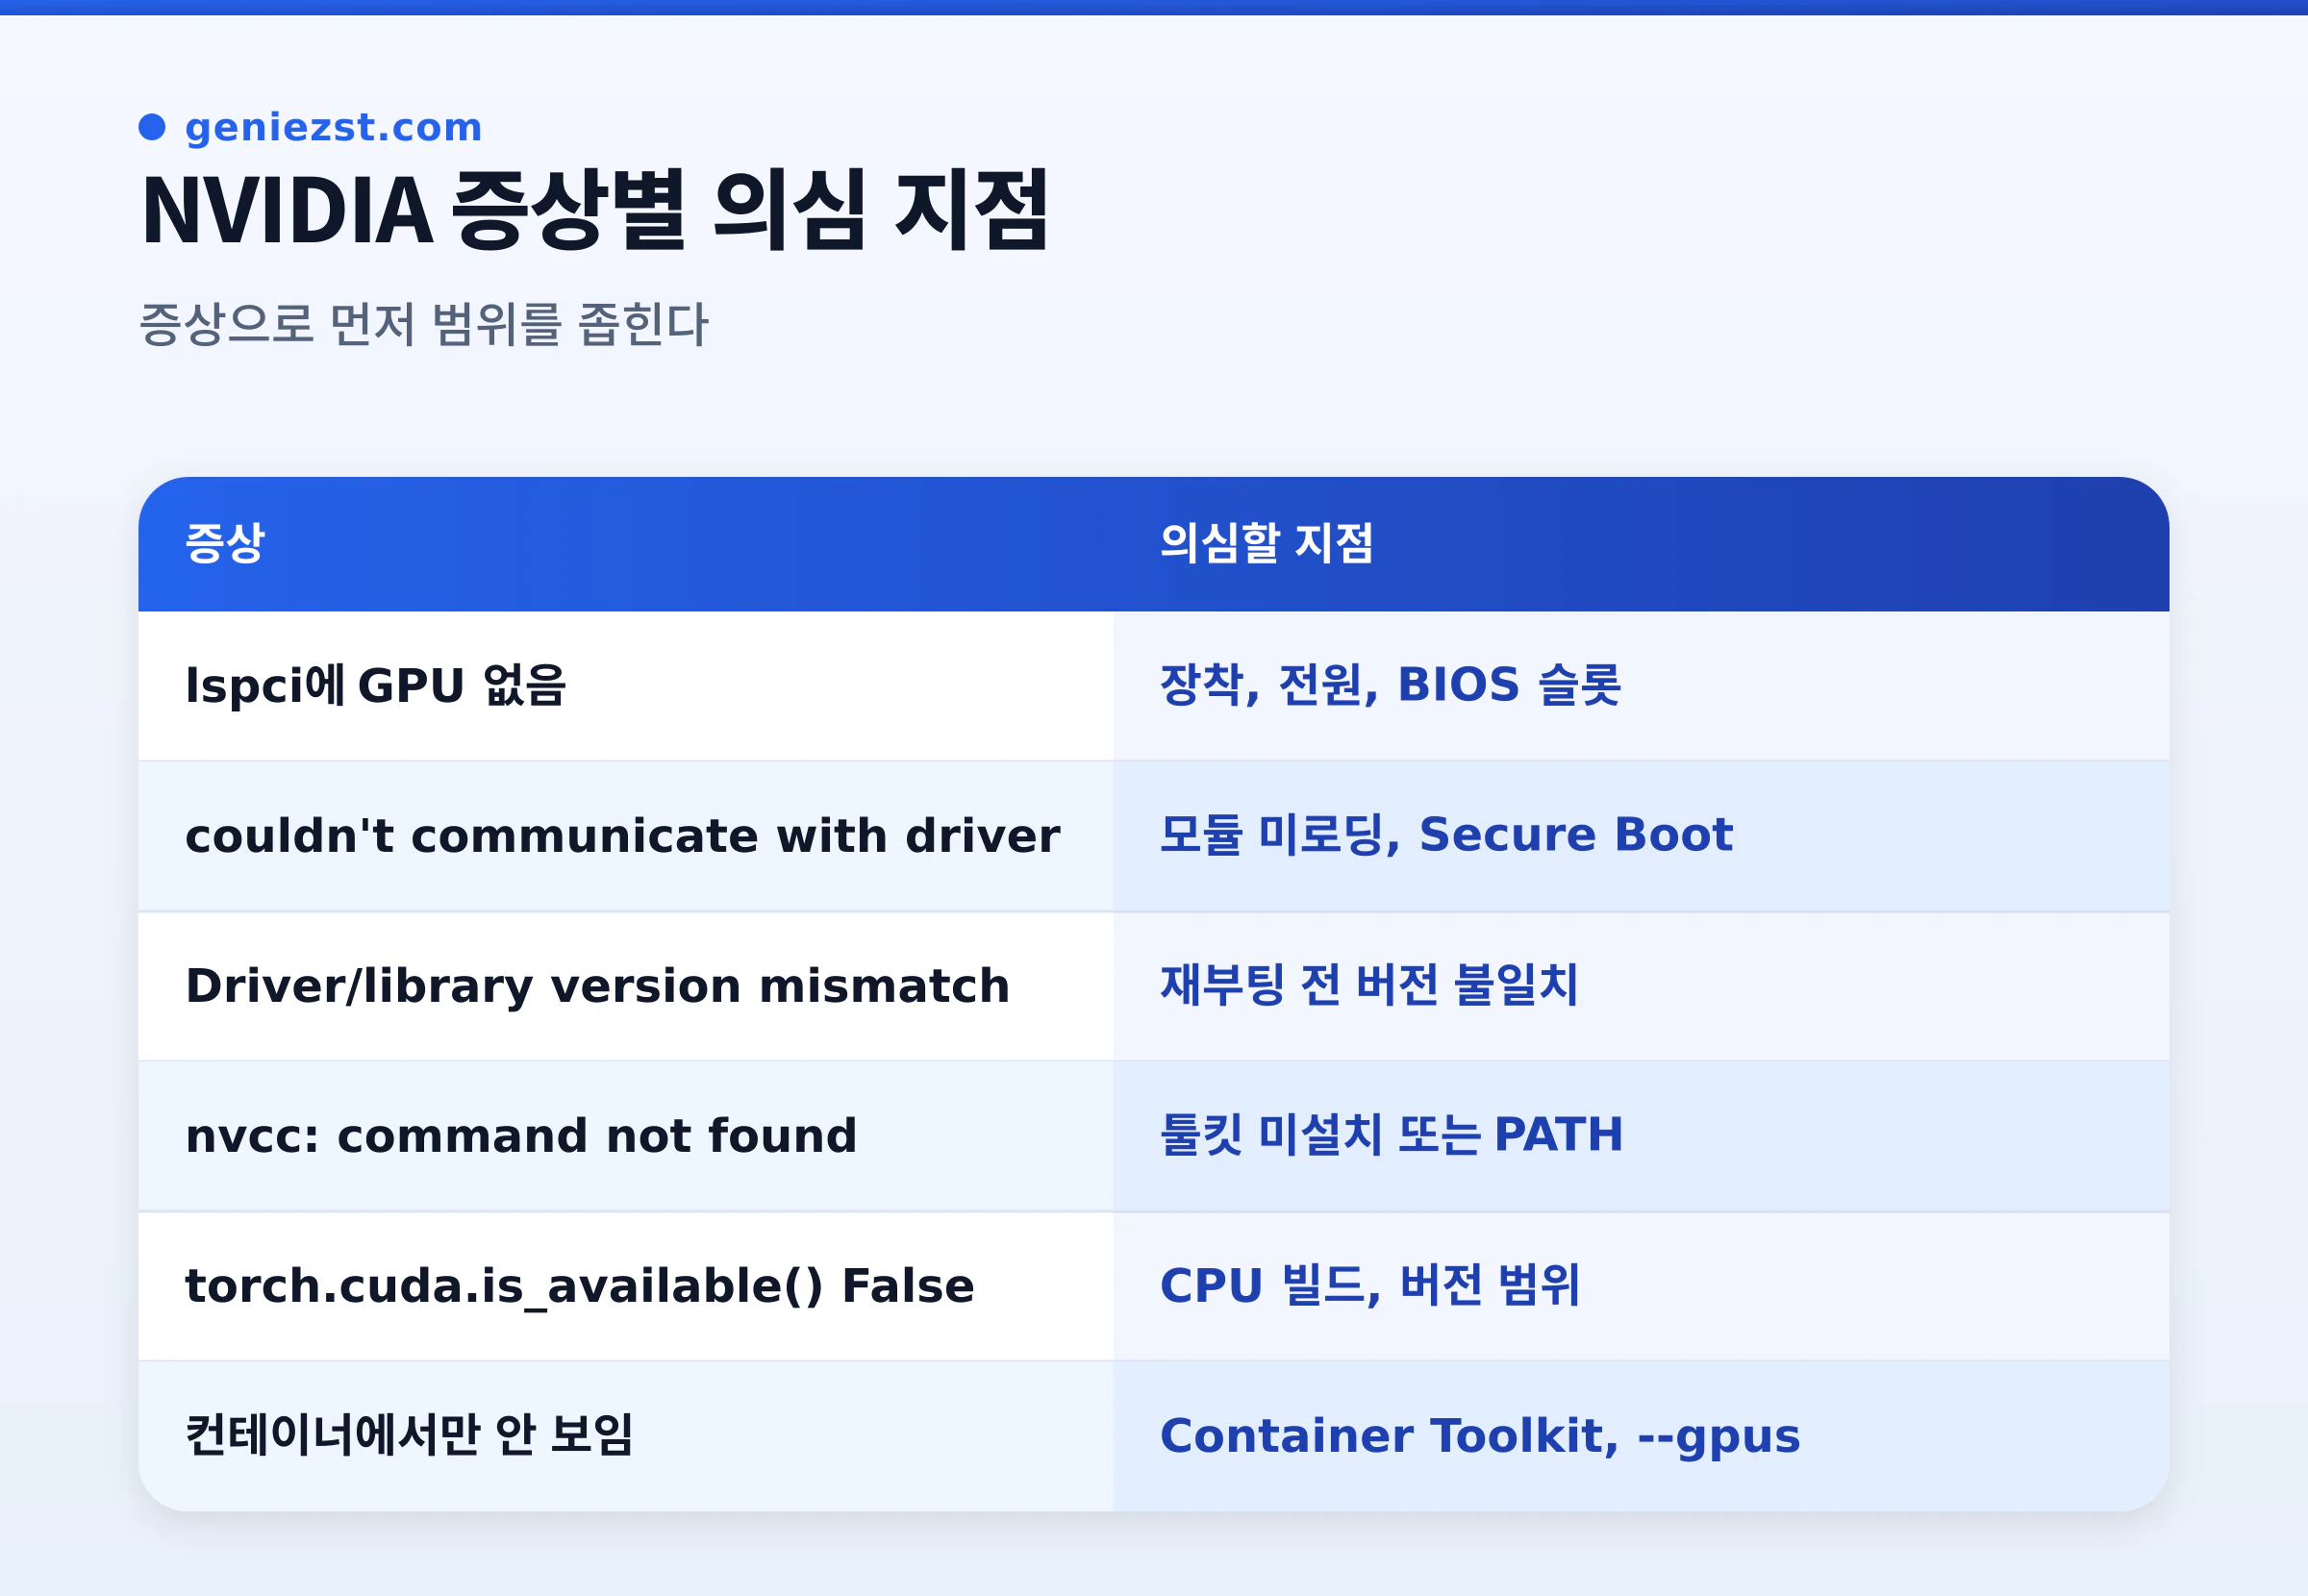
위에서부터 순서대로 보고, 처음 실패한 명령이 막힌 층입니다. nvcc가 없어도 nvidia-smi가 정상이면 드라이버 문제는 아닙니다. 아래 증상별로 갈래를 따라가세요.
nvidia-smi와 nvcc 버전이 다른 건 정상입니다
가장 많이 오해하는 부분입니다. nvidia-smi 오른쪽 위의 CUDA Version은 설치된 툴킷 버전이 아니라, 지금 설치된 드라이버가 지원하는 최고 CUDA 버전입니다. 반대로 nvcc --version은 설치된 툴킷의 버전을 보여 줍니다. 두 값이 달라도 툴킷 버전이 드라이버가 지원하는 범위 안이면 문제없습니다.
툴킷이 드라이버가 지원하는 버전보다 높으면 CUDA driver version is insufficient for CUDA runtime version 같은 오류가 납니다. 그때는 드라이버를 올리거나 툴킷을 낮추세요.
증상별 원인과 해결
lspci에 GPU가 없다
운영체제 이전의 문제입니다. 카드 장착, 전원 케이블, BIOS의 슬롯 설정과 PCIe 리셋을 점검하세요. 소프트웨어로는 해결되지 않습니다.
nvidia-smi가 "couldn't communicate with the NVIDIA driver"를 낸다
드라이버 커널 모듈이 올라오지 않았다는 뜻입니다. 순서대로 확인하세요.
lsmod | grep nvidia
sudo dmesg | grep -i -E "nvrm|nvidia"
mokutil --sb-state- 모듈이 없고
dmesg에Key was rejected by service가 있거나mokutil이SecureBoot enabled면 Secure Boot가 서명되지 않은 모듈을 막은 것입니다. - 커널을 최근에 올렸다면 새 커널용 모듈이 빌드되지 않았을 수 있습니다. DKMS 상태는
dkms status로 보고, 헤더가 없으면linux-headers-$(uname -r)를 설치한 뒤 다시 빌드하세요.
"Failed to initialize NVML: Driver/library version mismatch"
메모리에 올라온 커널 모듈의 버전과 새로 설치된 사용자 공간 라이브러리의 버전이 다를 때 납니다. 드라이버를 업데이트한 직후에 자주 생기고, dmesg에는 NVRM: API mismatch가 남습니다.
cat /proc/driver/nvidia/version     # 메모리의 모듈 버전
modinfo nvidia | grep ^version      # 디스크의 모듈 버전
두 값이 다르면 재부팅이 가장 확실합니다. 재부팅이 어려우면 GPU를 쓰는 프로세스를 모두 종료한 뒤 모듈을 내렸다가 다시 올릴 수 있지만, 디스플레이 서버가 쓰고 있으면 실패합니다.
Secure Boot 때문에 모듈이 거부된다
방법은 두 가지입니다. 하나는 BIOS에서 Secure Boot를 끄는 것이고, 다른 하나는 모듈에 서명한 뒤 MOK(Machine Owner Key)에 키를 등록하는 것입니다. 우분투에서 배포판이 제공하는 드라이버 패키지(ubuntu-drivers로 설치)는 서명된 모듈을 쓰며, 설치 중에 MOK 등록 암호를 묻고 재부팅 때 등록 화면이 나옵니다. 이 화면을 놓치면 모듈이 계속 거부되므로, 설치 후 첫 재부팅 때 화면을 확인하세요.
Nouveau와 충돌한다
lsmod | grep nouveau에 결과가 나오면 오픈소스 Nouveau 드라이버가 GPU를 잡고 있는 것입니다. 배포판 패키지로 설치하면 보통 블랙리스트가 같이 들어가지만, NVIDIA 런파일(.run)로 설치한 경우에는 직접 설정해야 합니다.
echo -e "blacklist nouveau\noptions nouveau modeset=0" | sudo tee /etc/modprobe.d/blacklist-nouveau.conf
sudo update-initramfs -u     # RHEL 계열은 sudo dracut --force
sudo reboot
nvcc: command not found
툴킷이 설치되지 않았거나 PATH에 없는 것입니다. 설치되어 있다면 경로만 추가하면 됩니다.
ls /usr/local | grep cuda
export PATH=/usr/local/cuda/bin${PATH:+:${PATH}}
export LD_LIBRARY_PATH=/usr/local/cuda/lib64${LD_LIBRARY_PATH:+:${LD_LIBRARY_PATH}}
계속 쓰려면 ~/.bashrc나 /etc/profile.d/cuda.sh에 넣으세요. 다만 PyTorch나 TensorFlow의 pip 설치본은 자체 CUDA 런타임을 포함하므로, 파이썬만 쓴다면 시스템 툴킷 없이 드라이버만 있으면 됩니다. nvcc는 CUDA 코드를 직접 컴파일할 때만 필요합니다.
파이썬에서 GPU가 안 보일 때
nvidia-smi는 정상인데 torch.cuda.is_available()이 False인 경우입니다.
python3 -c "import torch; print(torch.__version__, torch.version.cuda)"- 버전에
+cpu가 붙어 있으면 CPU 전용 빌드가 설치된 것입니다. GPU용 빌드로 다시 설치하세요. torch.version.cuda가 드라이버가 지원하는 범위보다 높으면 드라이버를 올려야 합니다.- 가상환경이나 컨테이너 안에서 실행하고 있다면 그 환경에서
nvidia-smi부터 확인하세요.
프레임워크와 CUDA, cuDNN 버전이 어긋나서 나는 오류는 PyTorch, TensorFlow CUDA·cuDNN 버전 불일치 해결에서 따로 다뤘습니다.
Docker 컨테이너에서 GPU가 안 보일 때
호스트에서는 nvidia-smi가 되는데 컨테이너 안에서만 안 된다면, 컨테이너에 GPU를 넘기는 NVIDIA Container Toolkit 설정을 확인하세요.
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
docker run --rm --gpus all ubuntu nvidia-smi
--gpus all 없이 실행하면 컨테이너에서는 GPU가 보이지 않습니다. Compose를 쓴다면 서비스에 deploy.resources.reservations.devices로 GPU를 지정해야 합니다. 이미지에는 드라이버가 들어 있지 않고, 호스트의 드라이버를 그대로 씁니다.
설치할 때 지켜야 할 것
- 설치 방법을 섞지 마세요. 배포판 패키지로 설치했다면 런파일(.run)을 덧씌우지 말고, 런파일을 쓰려면 기존 패키지를 먼저 제거하세요. 섞으면 모듈과 라이브러리 버전이 어긋나 위의 mismatch 오류가 생깁니다.
- 패키지로 설치하면 DKMS가 커널 업데이트 때 모듈을 다시 빌드해 줍니다. 런파일은
--dkms옵션을 줘야 같은 효과가 납니다. - 드라이버를 바꾼 뒤에는 재부팅하세요. 재부팅하지 않으면 이전 모듈이 남아 mismatch가 납니다.
- 자동 보안 업데이트가 커널이나 드라이버를 올릴 수 있습니다. 학습 서버처럼 안정성이 중요한 곳에서는 드라이버 패키지를 고정(hold)해 두는 것을 고려하세요.
lspci,lsmod,nvidia-smi순으로 막힌 층을 확인했나요?- Secure Boot 상태를
mokutil --sb-state로 확인했나요? - 드라이버를 올린 뒤 재부팅했나요?
- 컨테이너라면
--gpus all과 NVIDIA Container Toolkit 설정을 확인했나요?
자주 묻는 질문
CUDA 툴킷을 꼭 설치해야 하나요?
파이썬 프레임워크의 pip 설치본만 쓴다면 필요 없습니다. 드라이버만 있으면 됩니다. CUDA C++ 코드를 직접 컴파일하거나 소스에서 라이브러리를 빌드할 때만 툴킷이 필요합니다.
툴킷을 여러 버전 설치해도 되나요?
됩니다. /usr/local/cuda-12.x처럼 버전별 디렉터리에 설치되고, /usr/local/cuda 심볼릭 링크가 기본 버전을 가리킵니다. 특정 작업만 다른 버전을 쓰려면 그 셸에서 PATH와 LD_LIBRARY_PATH를 바꾸세요.
GPU 메모리 부족(OOM)은 드라이버 문제인가요?
대부분 아닙니다. 모델이나 배치 크기가 메모리보다 커서 나는 문제입니다. 배치 크기를 줄이고 nvidia-smi로 어떤 프로세스가 메모리를 쓰는지 확인하세요. 자세한 방법은 PyTorch CUDA OOM과 메모리 파편화 해결을 참고하세요.