
학습을 몇 시간 잘 돌리다가 갑자기 torch.OutOfMemoryError: CUDA out of memory로 멈추는 경우가 있습니다. 메시지를 보면 수 GiB가 "reserved but unallocated"로 남아 있다고 나오는데, 정작 512MiB를 못 받았다고 합니다.
이럴 때 배치 크기부터 줄이거나 루프마다 torch.cuda.empty_cache()를 넣는 경우가 많습니다. 둘 다 처리량을 깎는 방법이고, 원인이 파편화라면 효과도 작습니다. OOM 메시지에 이미 판단에 필요한 숫자가 들어 있으니 그것부터 읽습니다.
OOM 메시지의 숫자 읽기
최근 PyTorch의 OOM 메시지는 대략 이런 형식입니다. 아래 숫자는 설명을 위해 넣은 예시입니다.
torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 512.00 MiB.
GPU 0 has a total capacity of 23.53 GiB of which 118.00 MiB is free.
Including non-PyTorch memory, this process has 23.28 GiB memory in use.
Of the allocated memory 19.94 GiB is allocated by PyTorch, and 2.86 GiB is
reserved by PyTorch but unallocated. If reserved but unallocated memory is
large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid
fragmentation.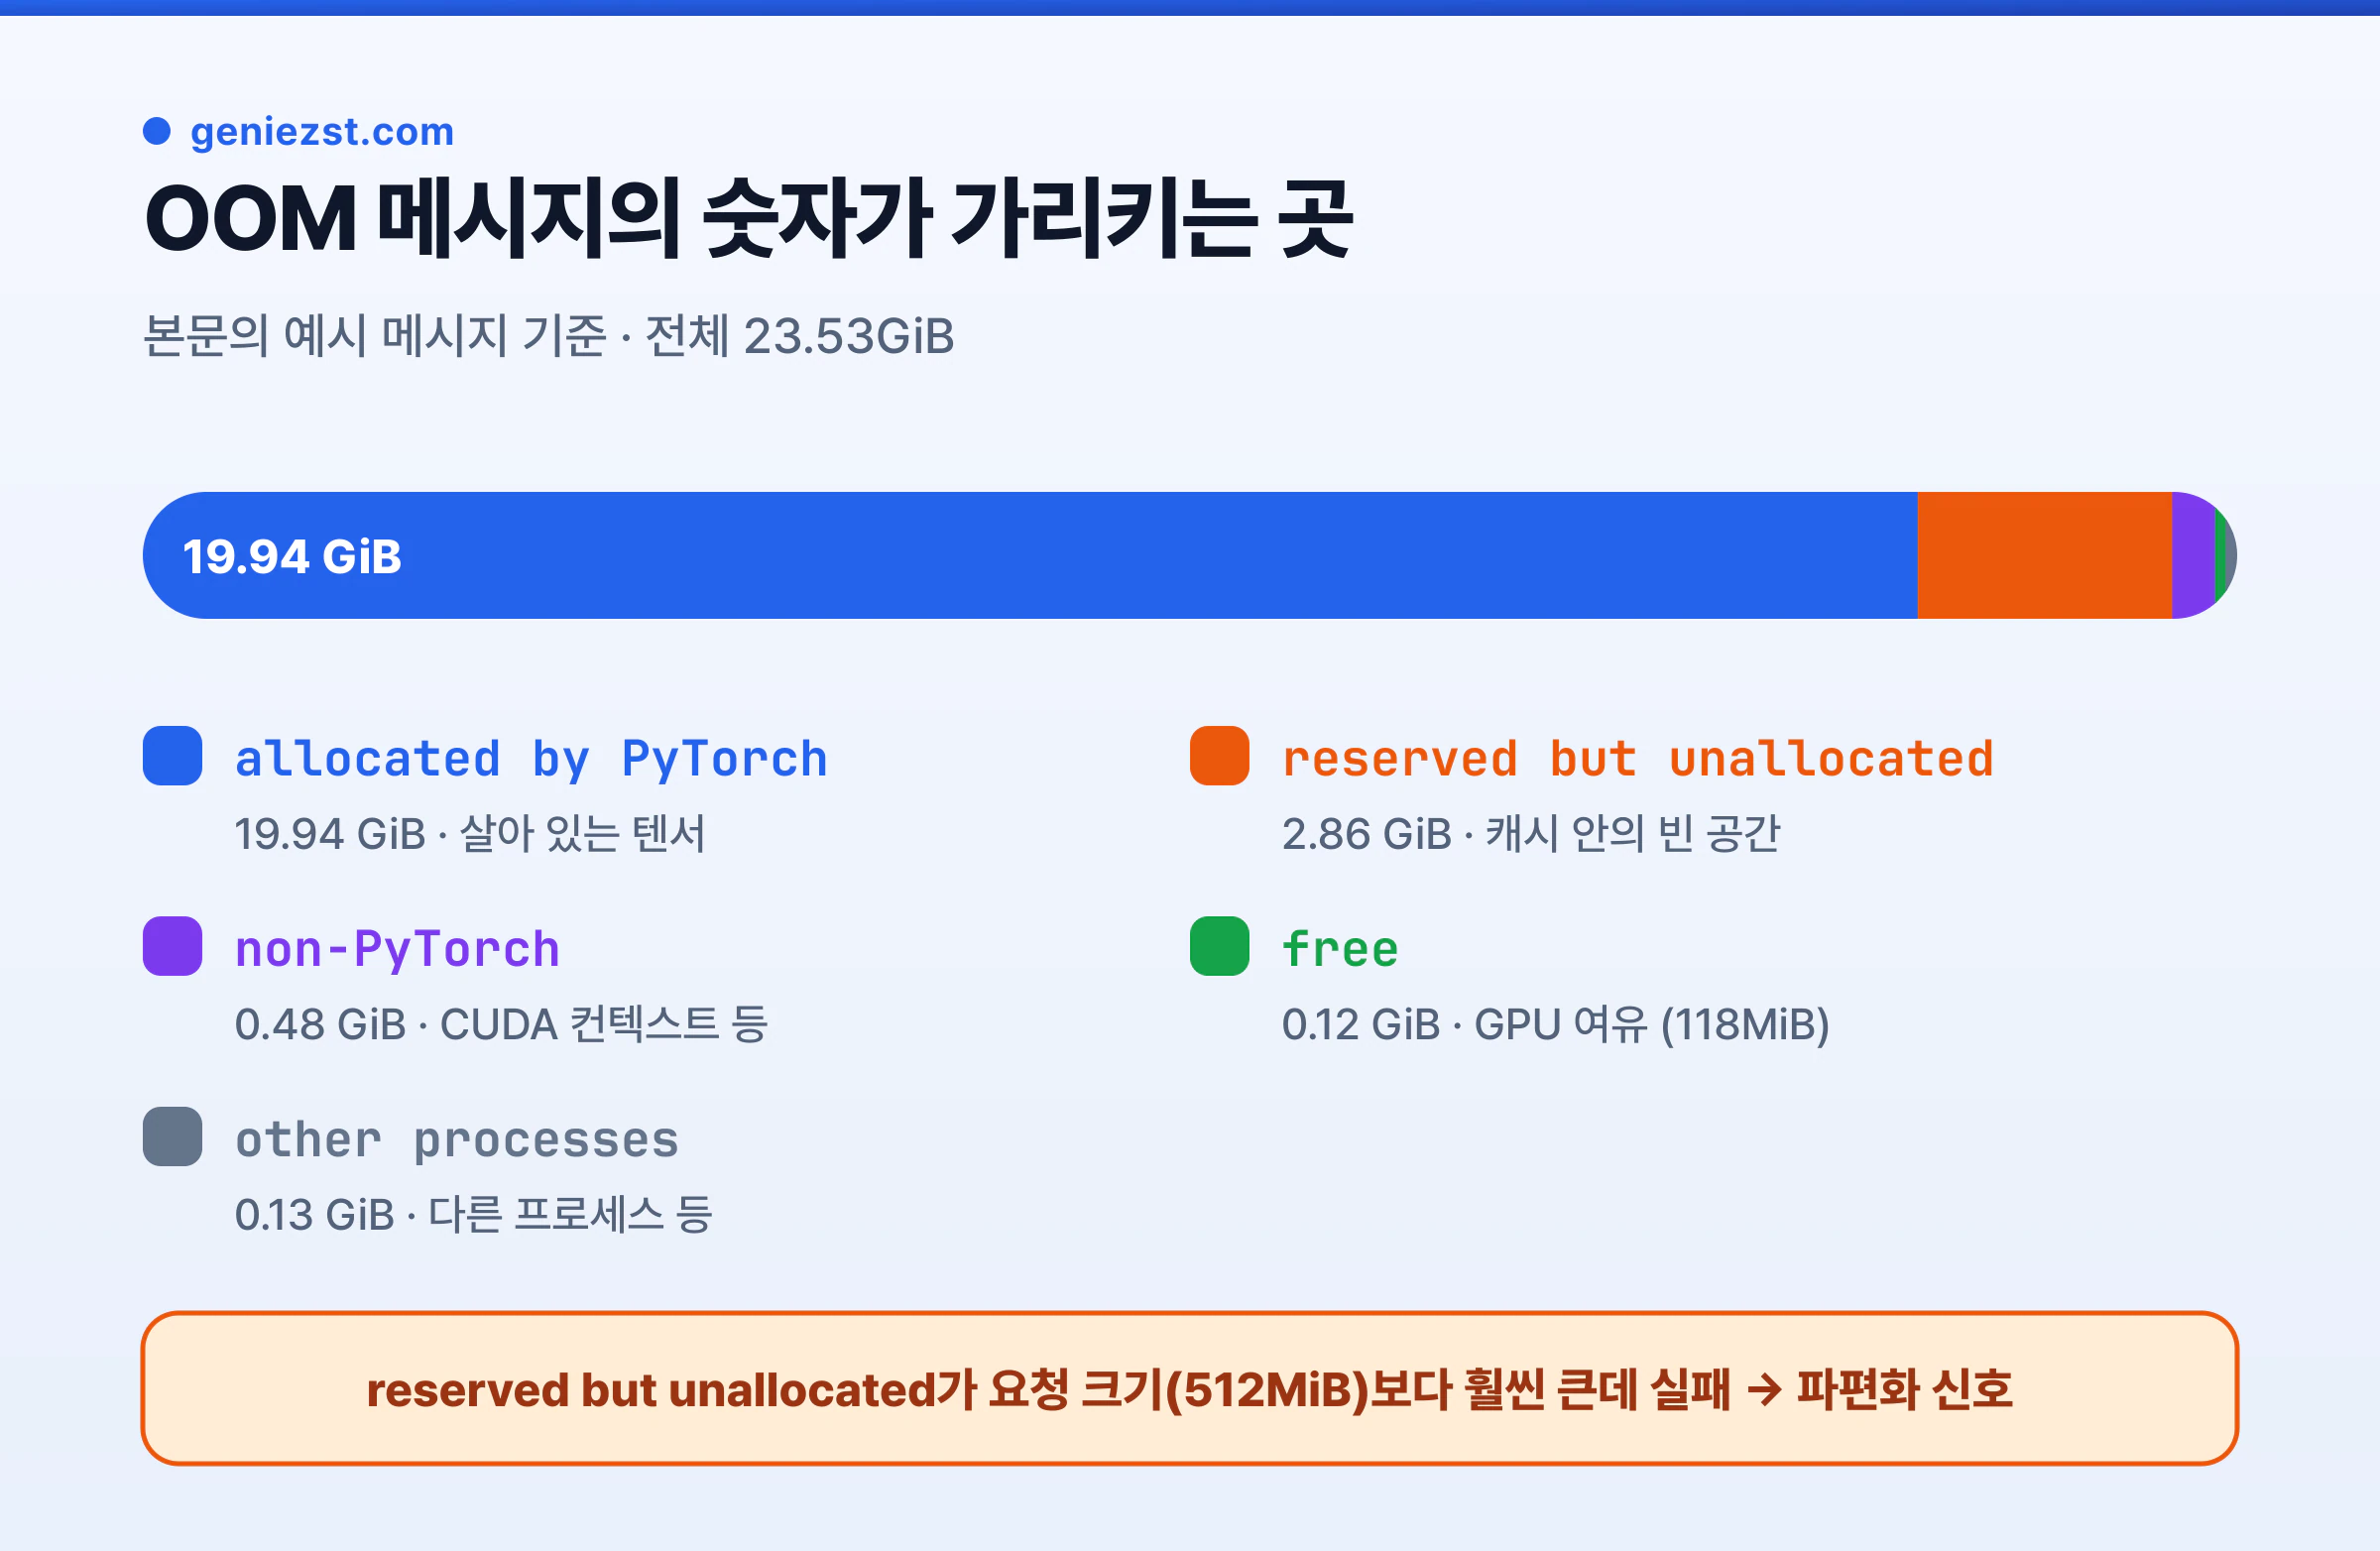
of which ... is free: GPU에서 아무도 쓰지 않는 메모리입니다. 새로cudaMalloc할 수 있는 여유입니다.allocated by PyTorch: 지금 살아 있는 텐서가 실제로 쓰는 양입니다.reserved by PyTorch but unallocated: PyTorch 할당자가 드라이버에서 받아 두었지만 지금은 비어 있는 캐시입니다.- 나머지(
in use에서 앞의 두 값을 뺀 양)는 CUDA 컨텍스트, cuBLAS·cuDNN 작업 공간처럼 PyTorch 캐시 밖에서 쓰는 메모리입니다.
판단 기준은 세 번째 값입니다. 요청 크기보다 훨씬 큰 양이 비어 있는데도 실패했다면, 빈 공간이 여러 세그먼트에 작은 조각으로 흩어져 있어 한 덩어리로 줄 수 없는 상태, 즉 파편화입니다. 반대로 이 값이 작다면 정말로 메모리가 모자란 것이니 배치 크기, 시퀀스 길이, 모델 크기, 혼합 정밀도 쪽을 봐야 합니다.
파편화가 생기는 구조
cudaMalloc과 cudaFree는 느리고, cudaFree는 장치 동기화까지 일으킵니다. 그래서 PyTorch는 캐싱 할당자를 씁니다. 드라이버에서 받은 메모리를 세그먼트로 들고 있다가 잘라서 텐서에 주고, 텐서가 사라져도 드라이버에 돌려주지 않고 캐시에 남겨 다음 요청에 다시 씁니다. nvidia-smi에 보이는 사용량이 텐서 크기보다 큰 이유가 이 캐시입니다.
PyTorch 문서는 파편화가 생기는 대표적인 예로 배치 크기가 반복마다 조금씩 바뀌는 경우를 듭니다. 큰 요청마다 요청 크기만 한 세그먼트를 새로 받는데, 배치가 N에서 N+1로 커지면 기존 세그먼트에 거의 들어가다가 끝부분이 조금씩 남습니다. 층이 50개 넘는 모델이면 이런 자투리가 수십 개 생기고, 합치면 GiB 단위인데 어느 하나도 다음 큰 요청을 담지 못합니다. 글 맨 위 그림의 왼쪽이 이 상태입니다.
expandable_segments 켜기
expandable_segments:True를 켜면 할당자가 요청마다 세그먼트를 따로 만들지 않고, 스트림마다 하나의 세그먼트를 만들어 필요할 때 끝에 물리 메모리를 이어 붙여 늘립니다. N+1 배치의 텐서들도 큰 세그먼트 하나 안에 차곡차곡 들어가니 자투리가 덜 생깁니다. 이미 흩어진 조각을 모아 주는 기능이 아니라 조각이 덜 생기게 하는 기능입니다.
설정 이름도 확인해 둡니다. 최신 PyTorch 문서에서는 PYTORCH_ALLOC_CONF가 정식 이름이고, PYTORCH_CUDA_ALLOC_CONF는 하위 호환을 위한 별칭입니다. 이전 버전에서는 PYTORCH_CUDA_ALLOC_CONF만 인식하니, 버전을 섞어 쓰는 환경이라면 예전 이름으로 두는 편이 무난합니다.
export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True
python train.py# Docker Compose라면 environment에 추가
services:
trainer:
image: pytorch/pytorch:latest
environment:
- PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True
shm_size: "8gb"
deploy:
resources:
reservations:
devices:
- driver: nvidia
count: all
capabilities: [gpu]할당자는 처음 CUDA 메모리를 쓸 때 이 값을 읽습니다. 코드 안에서 os.environ으로 넣으려면 import torch보다 앞에 두는 것이 안전합니다. 문서는 이 옵션을 아직 실험적 기능으로 표시하고, 기본값은 꺼짐입니다.
예전부터 쓰던 max_split_size_mb는 큰 캐시 블록을 잘게 쪼개지 못하게 막는 옵션입니다. 워크로드마다 적당한 값을 찾아야 해서, 먼저 expandable_segments를 켜 보고 그래도 자투리가 많을 때 같이 시험하는 순서를 권합니다. 두 옵션은 expandable_segments:True,max_split_size_mb:256처럼 쉼표로 함께 줄 수 있습니다. 둘 다 PyTorch 기본 할당자(backend:native)에서만 의미가 있고, backend:cudaMallocAsync를 쓰면 무시됩니다.
언제, 어디서 쪼개졌는지 보기
설정을 바꿔도 OOM이 나면 할당 기록을 남겨 직접 봅니다.
import torch

# 할당과 해제 기록을 시작 (스택 정보 포함)
torch.cuda.memory._record_memory_history(max_entries=100_000)

try:
    train_some_steps()
finally:
    # 스냅샷 저장 후 기록 중지
    torch.cuda.memory._dump_snapshot("oom_snapshot.pickle")
    torch.cuda.memory._record_memory_history(enabled=None)
저장한 파일을 PyTorch가 제공하는 메모리 시각화 페이지(pytorch.org/memory_viz)에 올리면 시간에 따른 할당 그래프와 세그먼트별 사용 상태가 나옵니다. 어떤 연산이 큰 텐서를 만들었는지, 세그먼트 끝에 자투리가 얼마나 남았는지가 보입니다.
간단히 수치만 보려면 이 정도로 충분합니다.
gib = 1024 ** 3
print("allocated", torch.cuda.memory_allocated() / gib)
print("reserved ", torch.cuda.memory_reserved() / gib)
print("peak     ", torch.cuda.max_memory_allocated() / gib)
print(torch.cuda.memory_summary(abbreviated=True))
코드에서 흔한 실수
파편화가 아니라 메모리를 실제로 붙잡고 있는 경우도 많습니다.
손실값을 로깅하려고 losses.append(loss)처럼 텐서를 그대로 모으면, 그 텐서에 연결된 계산 그래프가 함께 살아남습니다. loss.item()이나 loss.detach()로 값만 남깁니다.
검증과 추론에서는 역전파가 필요 없으니 torch.inference_mode()로 감쌉니다. torch.no_grad()보다 버전 추적 같은 부가 정보까지 생략해 조금 더 가볍습니다.
model.eval()
with torch.inference_mode():
preds = model(batch).argmax(dim=-1)torch.cuda.empty_cache()는 캐시의 빈 블록을 드라이버에 돌려줄 뿐 살아 있는 텐서의 메모리는 줄이지 않습니다. 문서도 이 함수로 PyTorch가 쓸 수 있는 메모리가 늘지는 않는다고 설명합니다. 같은 GPU를 다른 프로세스와 나눠 써야 할 때처럼 이유가 있을 때만 씁니다. 루프마다 부르면 다음 반복에서 다시 cudaMalloc을 해야 해서 느려집니다.
DataLoader 워커를 쓰는데 컨테이너에서 Bus error가 난다면 GPU가 아니라 공유 메모리 문제입니다. Docker의 기본 /dev/shm은 64MB라서 워커가 배치를 넘기다 모자랍니다. 위 Compose 예시처럼 shm_size를 늘리거나 ipc: host를 씁니다. 로컬 LLM을 컨테이너로 운영하는 구성은 Docker로 Ollama와 Open WebUI 구축하기에서 다뤘습니다.