
torch.cuda.is_available()이 False로 나오거나 학습을 시작하자마자 cuDNN 오류가 나는 경우, 대부분 "내 컴퓨터의 CUDA 버전"과 "프레임워크가 쓰는 CUDA 버전"을 같은 것으로 보고 맞추려다 꼬입니다. 이 둘은 다른 숫자입니다. 드라이버, 프레임워크 휠에 들어 있는 CUDA 런타임, 시스템에 설치한 CUDA Toolkit, GPU 아키텍처가 각각 따로 있고, 어디서 어긋났는지에 따라 고치는 방법이 다릅니다.
nvidia-smi의 CUDA 버전은 무엇인가
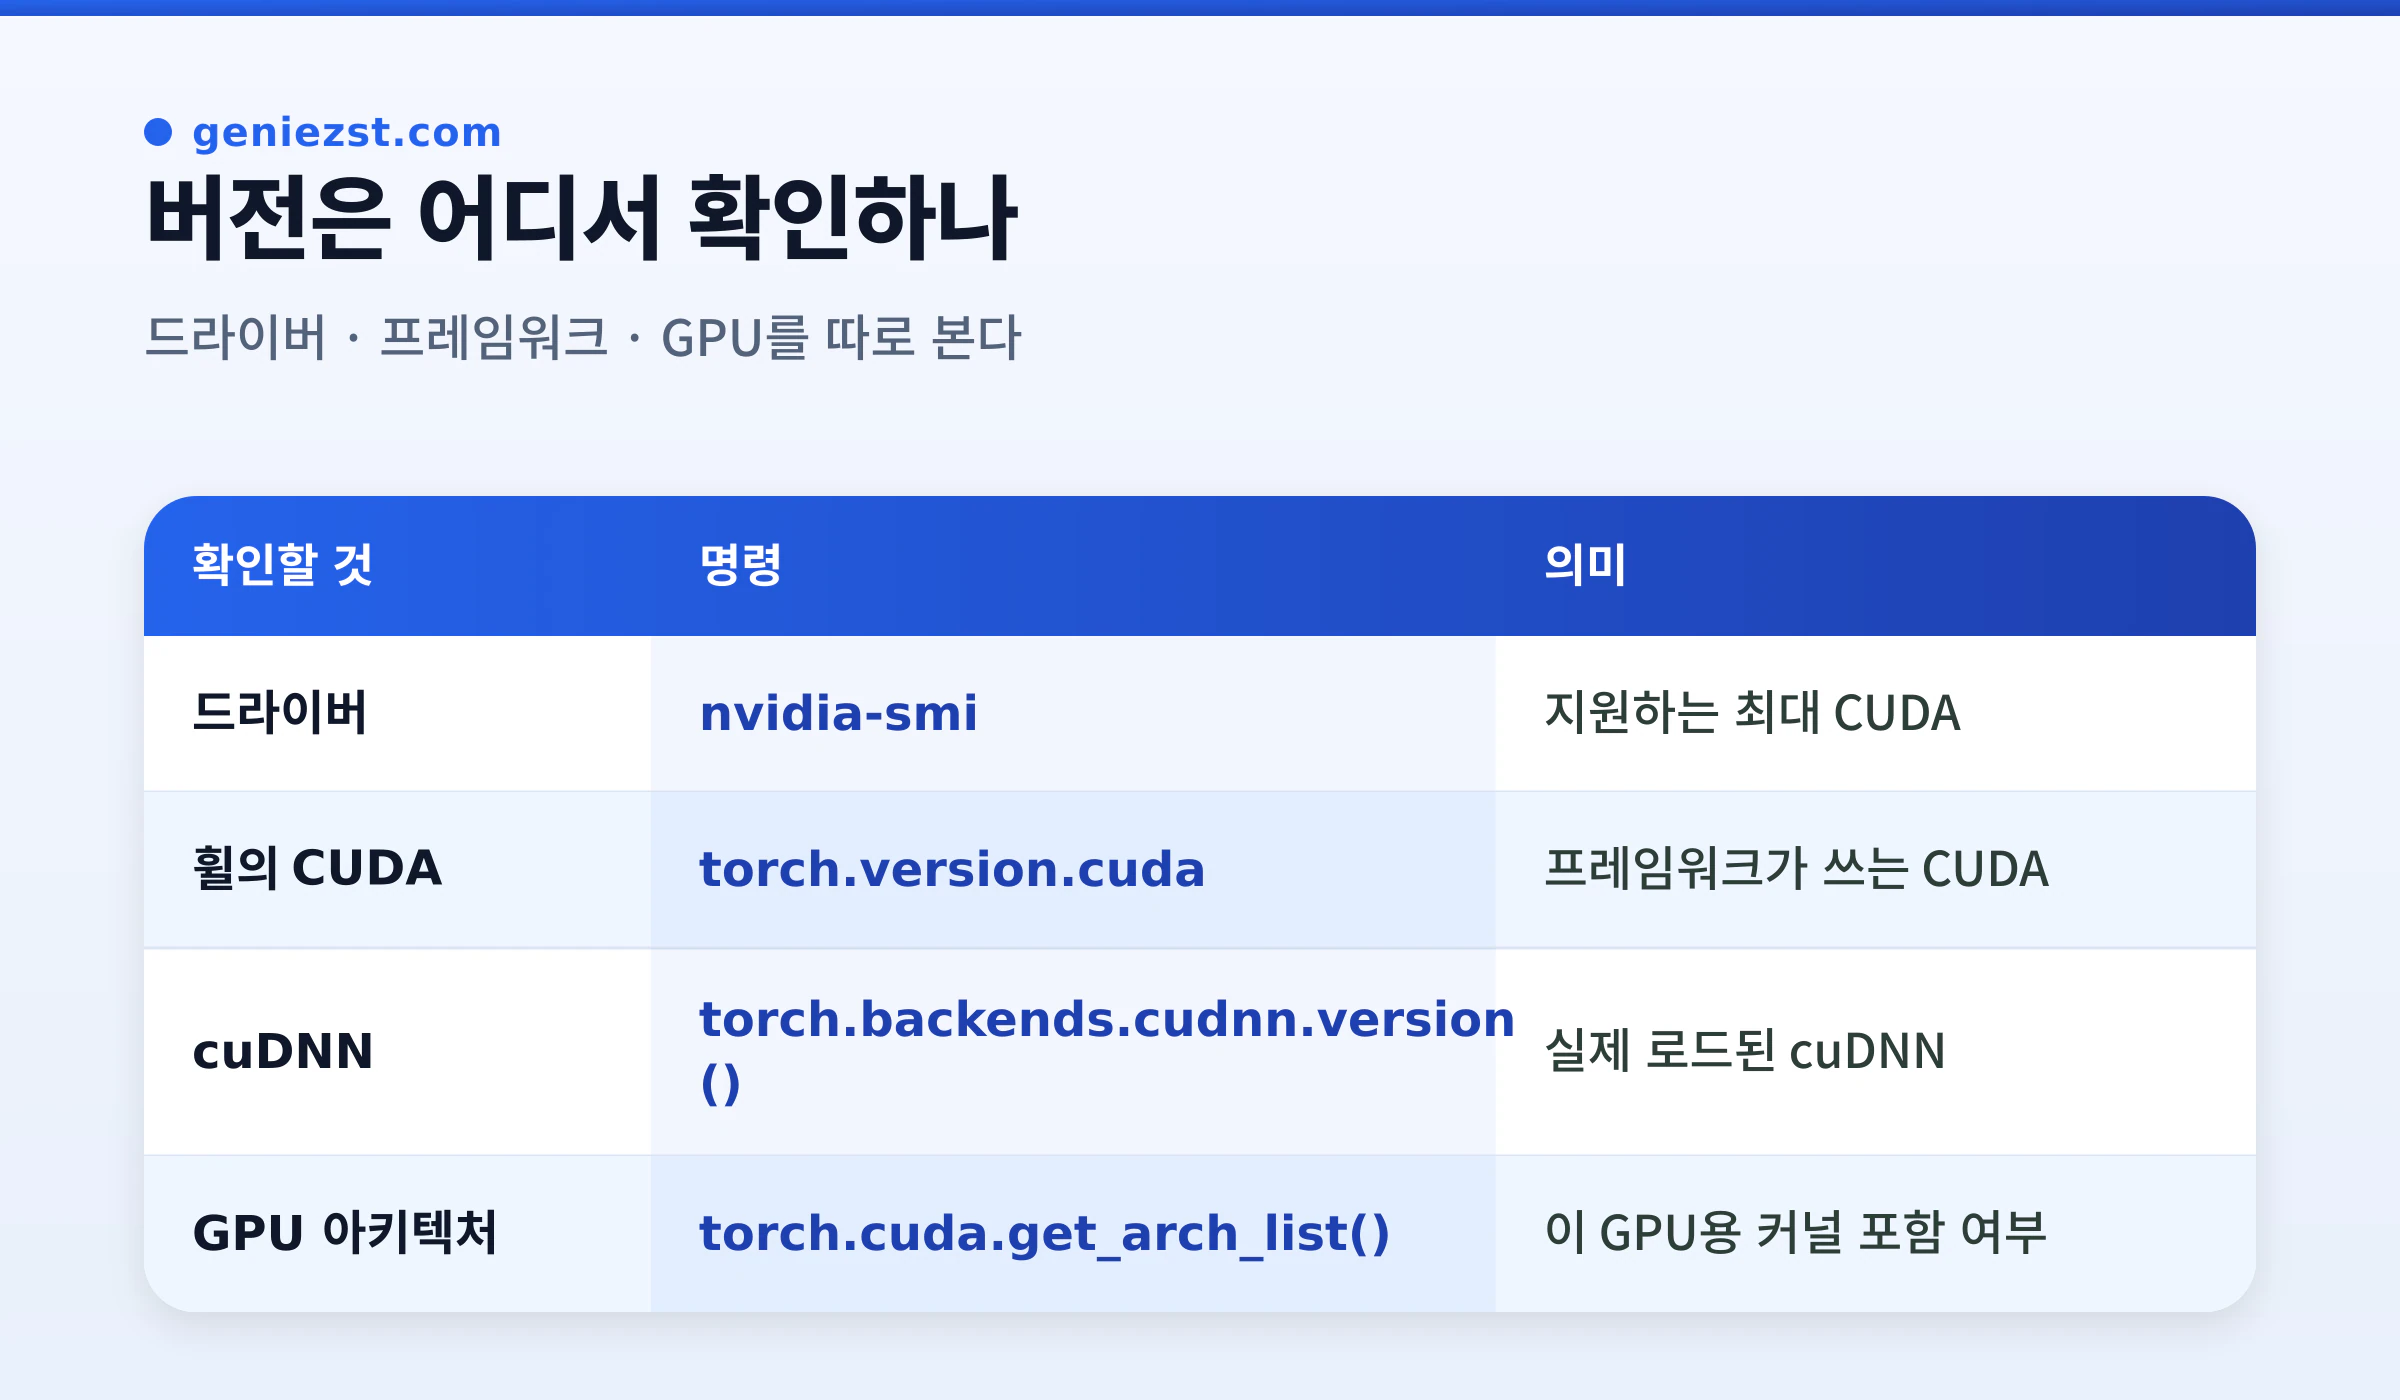
nvidia-smi 오른쪽 위의 CUDA Version은 설치된 Toolkit이 아니라, 이 드라이버가 지원하는 가장 높은 CUDA 런타임 버전입니다. 드라이버는 이 버전 이하의 CUDA로 빌드된 프로그램을 실행할 수 있습니다. 드라이버가 12.4를 보여 줘도 CUDA Toolkit이 설치돼 있다는 뜻은 아닙니다.
반대로 nvcc --version은 시스템에 설치된 Toolkit 버전입니다. PyTorch 공식 휠은 CUDA 런타임과 cuDNN을 휠 안에, 또는 의존 패키지로 함께 넣어 오기 때문에 PyTorch는 시스템 Toolkit이 없어도 동작하는 것이 보통입니다. 드라이버만 맞으면 됩니다.
CUDA 11 이후에는 마이너 버전 호환성이 적용되어, 같은 메이저 버전 안에서는 드라이버가 해당 메이저 버전의 최소 요구 버전만 넘으면 새 마이너 버전으로 빌드된 프로그램도 실행됩니다. 세부 요구 드라이버 버전은 NVIDIA의 CUDA 호환성 문서에서 확인하세요.
프레임워크가 실제로 쓰는 버전 확인
추측하지 말고 프레임워크에게 직접 물어보는 것이 가장 빠릅니다.
python -c "import torch; print(torch.__version__, torch.version.cuda, torch.backends.cudnn.version(), torch.cuda.is_available())"출력은 PyTorch 버전, 휠이 빌드된 CUDA 버전, cuDNN 버전, GPU 사용 가능 여부 순서로 한 줄에 나옵니다. torch.version.cuda가 None이면 CPU 전용 휠이 설치된 것입니다. 이 경우 어떤 드라이버를 깔아도 GPU를 쓰지 못합니다.
TensorFlow는 빌드 정보를 이렇게 확인합니다.
python -c "import tensorflow as tf; i = tf.sysconfig.get_build_info(); print(tf.__version__, i['cuda_version'], i['cudnn_version']); print(tf.config.list_physical_devices('GPU'))"GPU 목록이 빈 리스트이면 오류 로그에 Could not load dynamic library나 Cannot dlopen some GPU libraries 같은 줄이 있는지 먼저 봅니다. 어떤 .so 또는 .dll을 못 찾는지 알려 줍니다.
증상별로 어디가 어긋났는지
| 오류 메시지 | 원인 후보 |
|---|---|
CUDA driver version is insufficient for CUDA runtime version |
드라이버가 너무 오래됨 |
no kernel image is available for execution on the device |
휠이 이 GPU 아키텍처를 지원하지 않음 |
cuDNN version incompatibility ... compiled against (...) but found runtime version (...) |
다른 위치의 cuDNN이 먼저 로드됨 |
Could not load dynamic library 'libcudnn.so.8' |
TensorFlow가 요구하는 cuDNN을 못 찾음 |
torch.cuda.is_available()이 False |
CPU 전용 휠, 드라이버 미설치, 컨테이너에 GPU가 노출되지 않음 |
드라이버가 너무 낮다
nvidia-smi의 드라이버 버전이 휠이 요구하는 CUDA의 최소 드라이버보다 낮으면 위 첫 오류가 납니다. 휠을 낮은 CUDA용으로 바꾸는 것(예: cu118)이나 드라이버 업데이트 중 하나로 풉니다.
GPU 아키텍처 미지원
이 오류는 새 GPU에서 오래된 휠을 쓸 때 자주 납니다. RTX 50 시리즈 같은 최신 GPU는 CUDA 12.8 이상으로 빌드된 PyTorch가 필요합니다. 내 GPU의 compute capability와 휠이 지원하는 목록을 비교해 보세요.
python -c "import torch; print(torch.cuda.get_device_capability(0), torch.cuda.get_arch_list())"GPU의 capability(예: (12, 0))에 해당하는 sm_120 같은 항목이 arch 목록에 없으면, 더 새로운 CUDA로 빌드된 휠을 설치해야 합니다.
cuDNN이 다른 곳에서 로드된다
휠 안의 cuDNN 대신 시스템에 설치한 다른 버전의 cuDNN이 LD_LIBRARY_PATH에서 먼저 잡히면 incompatibility 오류가 납니다. 어떤 라이브러리가 실제로 로드되는지는 다음으로 확인합니다.
echo $LD_LIBRARY_PATH
ldconfig -p | grep -i cudnnLD_LIBRARY_PATH에 오래된 /usr/local/cuda-*/lib64가 들어 있다면, 해당 줄을 쉘 설정에서 지우거나 가상 환경 안에서만 비워서 다시 실행해 보세요.
env -u LD_LIBRARY_PATH python -c "import torch; print(torch.backends.cudnn.version())"이렇게 했을 때 정상이라면 원인은 환경 변수입니다.
PyTorch 재설치
버전이 어긋났다면 기존 패키지를 지우고 맞는 CUDA 인덱스로 다시 설치하는 것이 가장 확실합니다. 먼저 PyTorch 설치 페이지에서 내 환경의 명령을 확인하세요.
pip uninstall -y torch torchvision torchaudio
pip install torch torchvision torchaudio \
  --index-url https://download.pytorch.org/whl/cu128
cu128 부분이 CUDA 12.8용 휠입니다. 드라이버가 12.8을 지원하지 않는다면 cu126, cu118처럼 낮은 인덱스를 고르세요. 어떤 인덱스가 제공되는지는 PyTorch 버전마다 다릅니다. conda 채널로 PyTorch를 배포하는 것은 중단되었으므로 새 환경에서는 pip를 쓰는 편이 안전합니다.
설치 후 위의 한 줄 검사를 다시 실행해 True가 나오는지 확인합니다.
TensorFlow 재설치
TensorFlow는 PyTorch와 달리 CUDA/cuDNN 버전 매핑이 엄격합니다. Linux에서는 CUDA 라이브러리를 pip로 함께 설치하는 방법이 가장 단순합니다.
pip install "tensorflow[and-cuda]"이렇게 설치하면 TensorFlow가 요구하는 CUDA·cuDNN 라이브러리가 같은 가상 환경에 들어가므로 시스템 Toolkit과 충돌할 여지가 줄어듭니다. 네이티브 Windows는 TensorFlow 2.10이 GPU를 지원한 마지막 버전이고, 이후 버전은 WSL2에서 쓰는 것을 공식 문서가 안내합니다. 2.10은 CUDA 11.2와 cuDNN 8.1이 필요합니다.
컨테이너와 가상 환경에서
- Docker: GPU를 컨테이너에 넘기려면 호스트에 NVIDIA Container Toolkit이 있어야 하고 실행 시
--gpus all이 필요합니다. 컨테이너 안에서nvidia-smi가 보이지 않으면 프레임워크 문제가 아니라 GPU 노출 문제입니다. - 가상 환경: 프로젝트마다 환경을 따로 만들고
requirements.txt에 프레임워크 버전과--index-url을 함께 적어 두면 팀 전체가 같은 휠을 받습니다. - 시스템 Toolkit이 필요한 경우: 커스텀 CUDA 확장을 직접 컴파일할 때만
nvcc가 필요하고, 이때는nvcc --version이 프레임워크의 CUDA 버전과 같은 메이저 버전이어야 합니다.
자주 묻는 질문
nvidia-smi는 CUDA 12.x인데 PyTorch는 11.8로 설치돼도 되나요
됩니다. 드라이버는 자기가 지원하는 최대 버전 이하의 CUDA로 빌드된 프로그램을 실행합니다. 12.x 드라이버에서 cu118 휠은 정상 동작합니다.
CUDA Toolkit을 여러 버전 설치해도 되나요
가능합니다. 다만 PATH와 LD_LIBRARY_PATH 맨 앞에 어떤 경로가 오느냐에 따라 로드되는 라이브러리가 달라집니다. PyTorch 휠을 쓰는 한 시스템 Toolkit 버전은 신경 쓰지 않아도 됩니다.
LD_LIBRARY_PATH를 설정했는데도 cuDNN 오류가 계속 납니다
LD_LIBRARY_PATH를 더하기보다 비워 보세요. 휠 안의 라이브러리가 우선 쓰이게 하는 것이 목적입니다. 그래도 같으면 가상 환경을 새로 만들어 다시 설치하는 것이 빠릅니다.