- 오픈AI '닷' 공개: 사용자가 프롬프트를 닫아도 백그라운드에서 24시간 작업을 지속하는 자율형 AI 에이전트 서비스 출시
- AWS 서울 리전 클로드 5 배포: 앤트로픽의 최신 플래그십 모델 오퍼스 및 소넷 5가 국내 리전에 정식 배치되어 레이턴시 대폭 개선
- 클라우드 보안 플랫폼 통합: 메가존클라우드가 크라우드스트라이크와 파트너십을 체결하고 엔드포인트부터 멀티클라우드 환경 전반의 위협 대응 현대화 착수
- 추론 최적화와 라이선스 논쟁: 중국 연구진의 KV 캐시 최적화 기술 도입을 둘러싼 서구 AI 생태계의 기술 수용 및 저작권 공방 심화
[AI] 오픈AI, 24시간 자율 구동되는 상시형 AI 에이전트 '닷' 공개
사진 출처: 경향신문
출처: 경향신문 발행: 2026-10-01 | 신뢰도: 기술 미디어
- 오픈AI가 사용자의 세션이 종료된 상태에서도 작업을 능동적으로 이어가는 상시형 AI 에이전트 서비스 '닷(Dot)'을 공개함
- 단발성 텍스트 응답을 넘어 외부 API 제어, 파일 시스템 조작, 주기적 스케줄링 태스크를 자율적으로 완수하는 구조를 도입함
- 에이전트의 비동기적 권한 실행에 따른 보안 위험과 자율 행동 제어 이슈로 인해 규제 당국의 감시와 안전성 검증 요구가 가중됨
실무 시사점
상시 가동형 AI 에이전트의 등장은 애플리케이션 아키텍처를 '요청-응답(Request-Response)' 모델에서 '비동기 이벤트 루프(Asynchronous Event Loop)' 기반으로 강제 전환시킵니다. 에이전트가 데이터베이스 읽기/쓰기 및 서드파티 결제, 메일 발송 권한을 자율적으로 행사할 경우 최소 권한 원칙(Principle of Least Privilege)과 세분화된 토큰 스코프 관리가 필수적입니다. 특히 장기 실행 프로세스(Long-running process)가 외부 리소스를 호출하는 과정에서 발생하는 좀비 세션과 네트워크 소켓 누적 문제를 방지하기 위한 워치독(Watchdog) 및 타임아웃 서킷 브레이커 설계가 인프라 레벨에서 동반되어야 합니다.
관련 가이드: TIME_WAIT 소켓 누적과 포트 고갈 해결
---## [클라우드] AWS, 서울 리전에 앤트로픽 클로드 오퍼스 및 소넷 5 정식 공급
사진 출처: 바이라인네트워크
출처: 바이라인네트워크 발행: 2026-10-01 | 신뢰도: 공식 발표
- 아마존웹서비스(AWS)가 아마존 베드록(Amazon Bedrock) 서울 리전을 통해 앤트로픽의 최신 모델 '클로드 오퍼스 5'와 '클로드 소넷 5'를 출시함
- 글로벌 리전을 경유할 때 발생하던 패킷 왕복 지연시간(RTT)을 대폭 단축하여 국내 엔터프라이즈 환경의 도입 속도가 가속화될 전망임
- 국내 금융 및 공공 규제 기준인 데이터 국외 이전 이슈를 해결함과 동시에 프라이빗 VPC 엔드포인트를 통한 보안 연결을 지원함
실무 시사점
그동안 미국(us-east-1 등) 리전을 통해 클로드 API를 호출하던 국내 엔지니어링 팀은 네트워크 RTT로 인한 수백 밀리초 단위의 지연을 감수해야 했습니다. 서울 리전 배치로 인해 대규모 RAG(검색 증강 생성) 시스템이나 실시간 추론 파이프라인의 엔드투엔드 레이턴시를 획기적으로 낮출 수 있게 되었습니다. 엔터프라이즈 환경에서는 데이터 주권(Data Residency) 요구사항을 충족함과 동시에 AWS PrivateLink를 구성하여 퍼블릭 인터넷 노출 없는 안전한 인프라 망 분리를 적용해야 합니다. 또한 배치 작업 시 서블릿 스레드 고갈이나 백엔드 리버스 프록시의 핸드셰이크 지연을 최소화하기 위해 커넥션 풀 튜닝을 선행해야 합니다.
---## [보안] 메가존클라우드, 크라우드스트라이크와 '보안 운영 현대화' 파트너십 체결
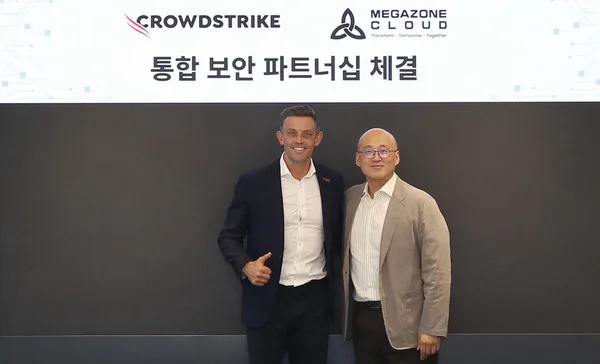
사진 출처: 테크M
출처: 테크M 발행: 2026-10-01 | 신뢰도: 공식 발표
- 메가존클라우드가 글로벌 사이버보안 기업 크라우드스트라이크와 손잡고 기업 보안 운영 센터(SOC) 현대화 지원에 돌입함
- 엔드포인트 탐지 및 대응(EDR) 솔루션인 팔콘(Falcon) 플랫폼을 클라우드 보안 태세 관리(CSPM)와 연계하는 체계 구축
- 멀티클라우드 환경 전반에 걸친 보안 위협 실시간 탐지와 위협 인텔리전스 기반의 자동화된 오케스트레이션 제공이 핵심 골자임
실무 시사점
쿠버네티스와 마이크로서비스 아키텍처(MSA)가 확산됨에 따라 단순 엔드포인트 보안을 넘어 컨테이너 런타임 보안과 클라우드 아이덴티티(CIEM)의 통합 가시성 확보가 필수가 되었습니다. 크라우드스트라이크와 같은 통합 EDR/XDR 에이전트를 리눅스 노드에 배포할 때, 커널 모듈 추적 및 eBPF 프로브 동작으로 인한 시스템 파일 디스크립터 점유율 급증을 모니터링해야 합니다. 워크로드가 폭증하는 피크 타임에 보안 데몬이 시스템 리소스(FD, CPU)를 과도하게 선점하여 비즈니스 컨테이너가 중단되는 사태를 막으려면 cgroups 기반의 리소스 쿼터 격리가 사전에 정밀하게 구성되어야 합니다.
---## [AI/인프라] 빅테크의 이중성 논란... 오픈소스 추론 최적화 기술 도입과 라이선스 공방
사진 출처: GeekNews
출처: GeekNews 발행: 2026-10-01 | 신뢰도: 개발자 커뮤니티
- 서구권 주요 AI 기업들이 중국 연구진의 모델 증류(Distillation) 행위를 강하게 비판하면서도 정작 중국발 추론 최적화 기법을 도입하고 있다는 지적이 제기됨
- 딥시크(DeepSeek)가 오픈소스로 공개한 다중 헤드 잠재 어텐션(MLA) 기반 KV 캐시 최적화 기술은 롱 컨텍스트 코딩 환경에서 메모리 사용량을 수백 배 감축함
- LLM 서빙 프레임워크 전반이 해당 최적화 로직을 채택하면서 고비용 인프라 운영 패러다임이 효율성 중심으로 급격히 재편 중임
실무 시사점
서빙 인프라 관점에서 KV 캐시(Key-Value Cache)는 대규모 컨텍스트를 처리할 때 GPU VRAM 고갈을 일으키는 주범입니다. 딥시크 방식의 잠재 벡터 압축 최적화 기법을 서빙 클러스터에 도입하면 vLLM이나 TGI 인프라의 동시 처리량(Throughput)을 비약적으로 개선할 수 있습니다. 하지만 모델 파라미터 경량화와 텐서 압축 파이프라인을 온프레미스 GPU 클러스터에 적용하는 엔지니어는 파이토치(PyTorch) 런타임 단계에서 발생하는 메모리 단편화(Memory Fragmentation) 현상과 텐서 할당 실패(OOM) 리스크를 엄밀히 추적하고 최적의 할당자(Allocator) 파라미터를 세팅해야 합니다.
관련 가이드: PyTorch CUDA OOM 에러와 메모리 파편화 해결