
트래픽이 몰리는 시간에만 nginx 에러 로그에 connect() failed (99: Cannot assign requested address)가 찍히고 일부 요청이 502로 끝나는 경우가 있습니다. 백엔드는 멀쩡하고 CPU도 남는데, ss -s를 보면 TIME_WAIT가 수만 개 쌓여 있습니다.
에러 99는 EADDRNOTAVAIL입니다. 새 연결을 만들 때 쓸 로컬 포트를 커널이 고르지 못했다는 뜻입니다. 연결을 받는 서버 쪽 문제가 아니라, 연결을 거는 쪽(프록시나 API 클라이언트)의 임시 포트가 바닥난 것입니다.
실제로 포트가 모자란지 확인
먼저 상태별 소켓 수와, 문제의 목적지로 향하는 소켓만 따로 셉니다.
# 전체 요약 (TCP 줄의 timewait 값을 확인)
ss -s

# 특정 업스트림(10.0.2.100:8080)으로 가는 소켓의 상태별 개수
ss -tan state all dst 10.0.2.100:8080 | awk 'NR>1 {print $1}' | sort | uniq -c

# 현재 임시 포트 범위
sysctl net.ipv4.ip_local_port_range
목적지 하나로 가는 TIME-WAIT 개수가 임시 포트 범위의 크기에 가까우면 포트 고갈이 맞습니다. 전체 TIME_WAIT가 많아도 목적지가 여러 곳으로 흩어져 있다면 포트는 모자라지 않습니다. 커널은 출발지 IP·포트, 목적지 IP·포트 네 값의 조합이 겹치지만 않으면 같은 로컬 포트를 다른 목적지에 다시 쓸 수 있기 때문입니다.
왜 TIME_WAIT가 포트를 묶어 두나
TCP 연결을 먼저 끊는 쪽(먼저 FIN을 보낸 쪽)은 마지막 ACK를 보낸 뒤 바로 소켓을 지우지 않고 TIME_WAIT로 기다립니다. 이유는 두 가지입니다.
- 마지막
ACK가 유실되면 상대가FIN을 다시 보내는데, 그때 다시ACK로 답해 줘야 합니다. - 네트워크에 늦게 떠돌던 이전 연결의 패킷이, 같은 포트 조합으로 새로 맺은 연결에 섞여 들어가는 것을 막습니다.
글 맨 위 그림이 이 순서를 보여 줍니다. 클라이언트가 먼저 FIN을 보내면 TIME_WAIT는 클라이언트 쪽에 남습니다.
리눅스는 이 대기 시간을 커널 상수 TCP_TIMEWAIT_LEN으로 60초에 고정해 두었습니다. sysctl로 줄일 수 있는 값이 아닙니다. 자주 같이 언급되는 tcp_fin_timeout은 FIN_WAIT_2 상태에서 기다리는 시간이라 TIME_WAIT 길이와는 관계가 없습니다.
프록시가 요청마다 백엔드와 연결을 새로 맺고 먼저 끊는 구조라면 TIME_WAIT는 프록시 쪽에 쌓입니다. 목적지가 10.0.2.100:8080 하나뿐이면 바꿀 수 있는 값은 출발지 포트 하나뿐이니, 계산은 단순합니다.
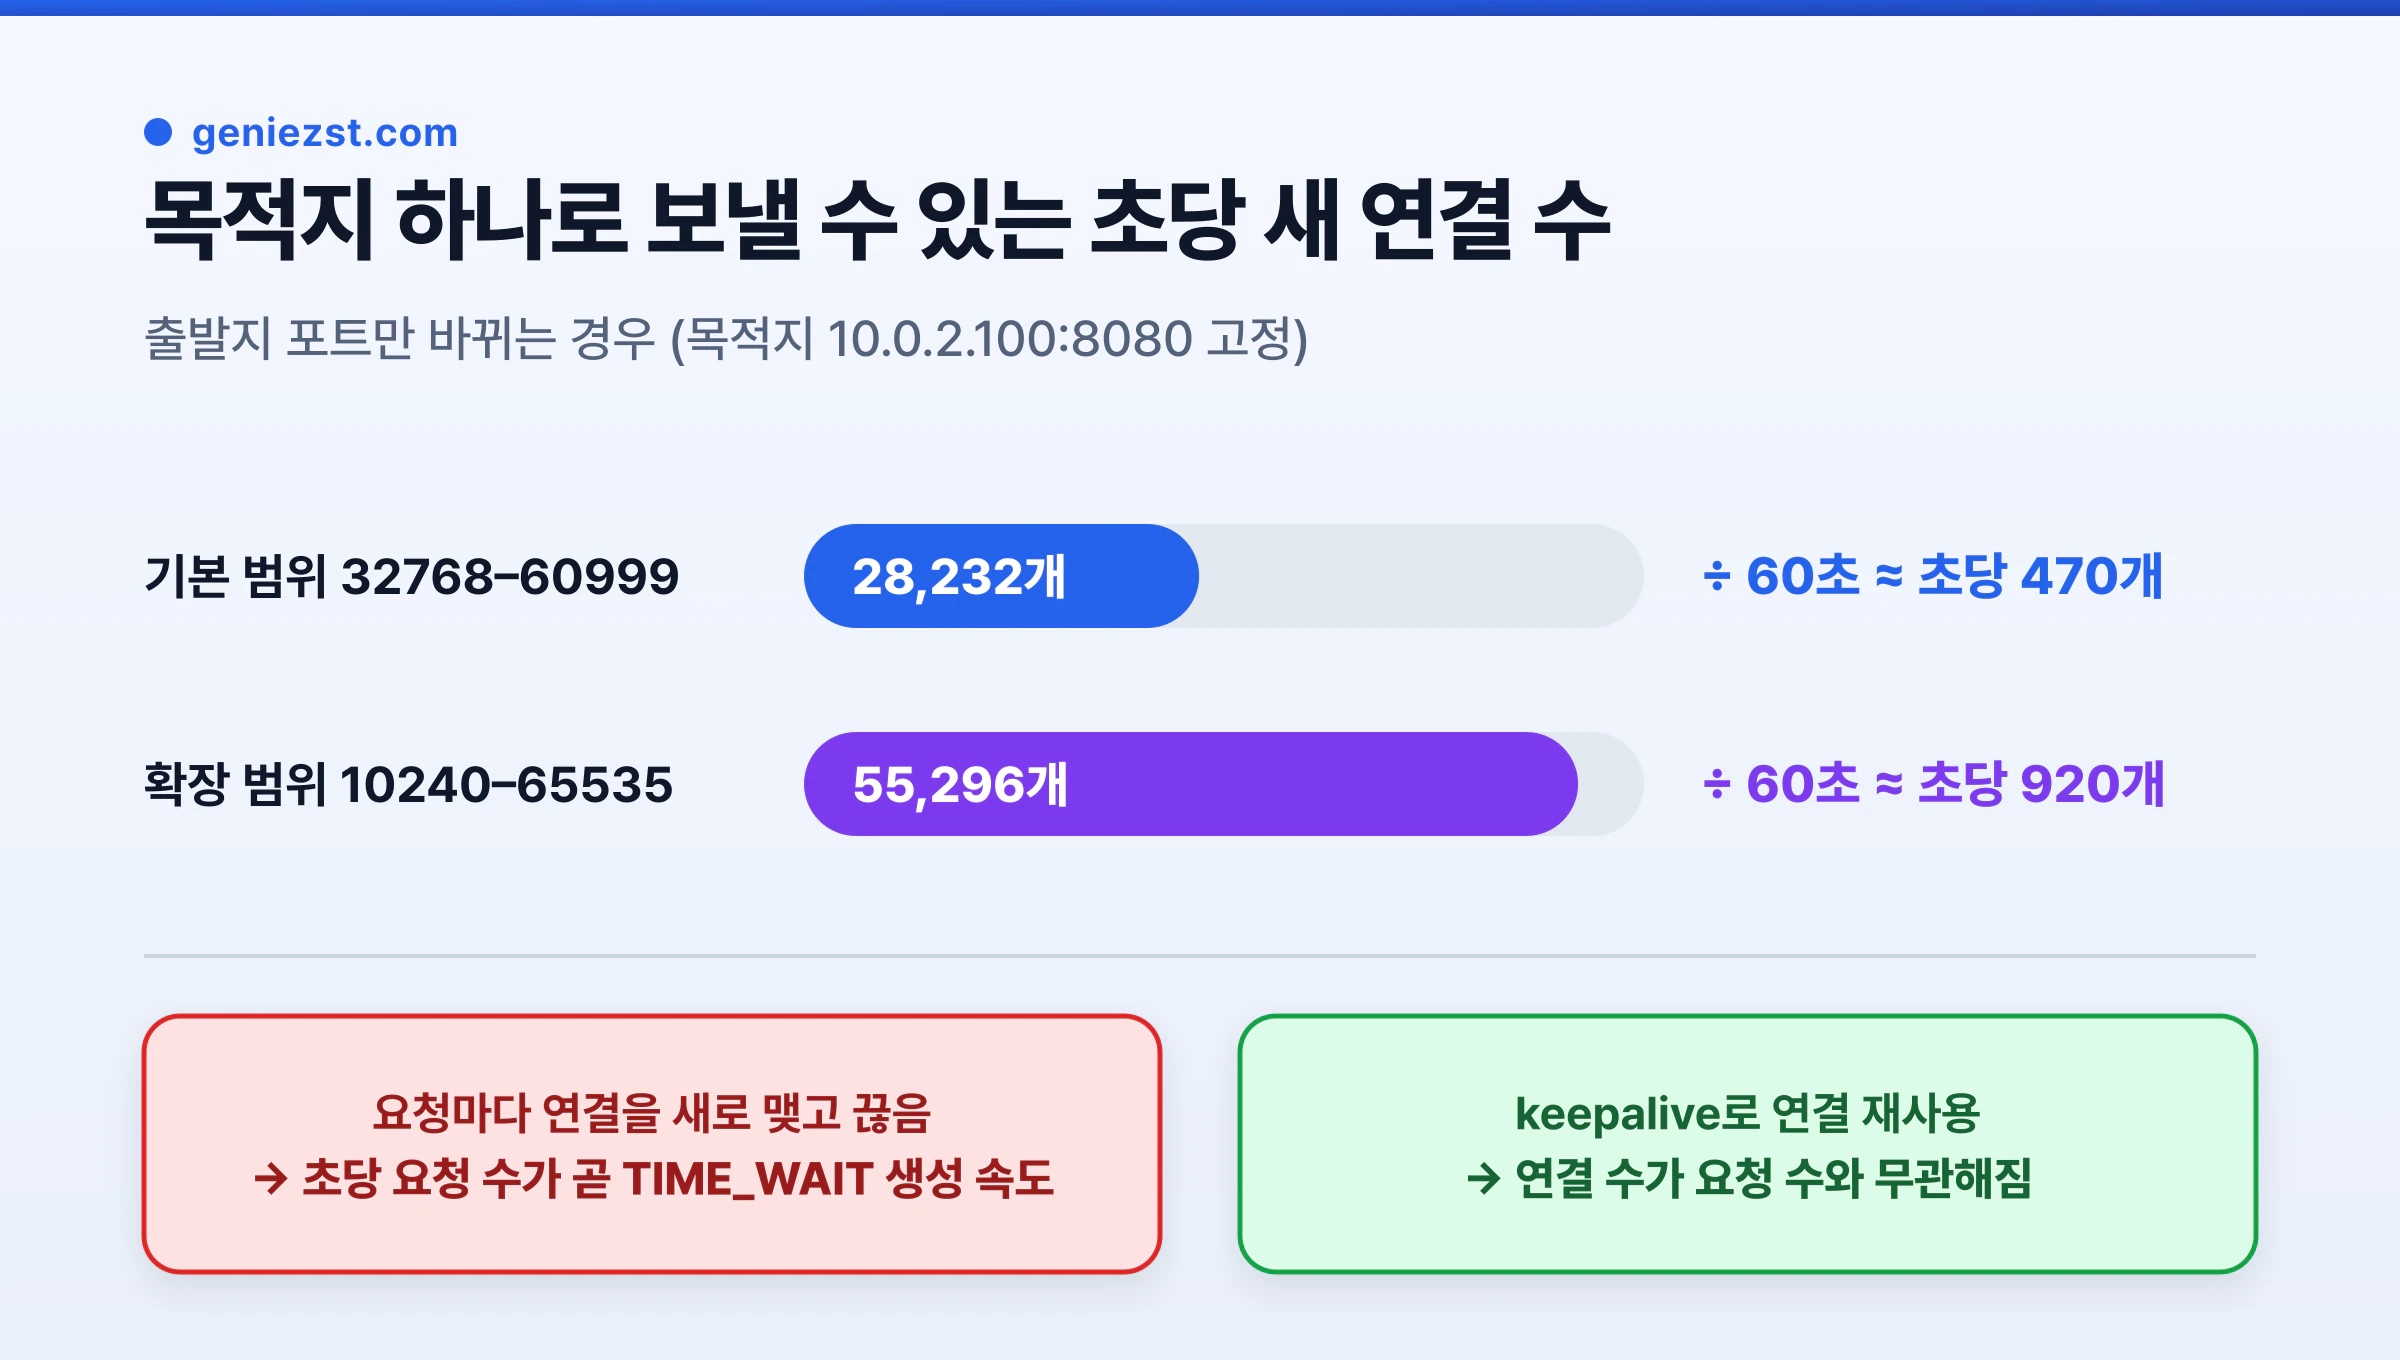
기본 범위 32768~60999에는 포트가 28,232개 있습니다. 하나가 60초씩 묶이면 같은 목적지로 초당 약 470개 이상 새 연결을 만들 때부터 포트가 모자랍니다. 범위를 넓히면 숫자는 커지지만 구조는 같습니다. 그래서 해결 순서는 연결을 덜 만드는 쪽이 먼저입니다.
1순위는 연결 재사용
요청마다 연결을 맺고 끊지 않으면 TIME_WAIT 자체가 거의 생기지 않습니다.
nginx upstream keepalive
nginx 1.29.7부터는 upstream keepalive가 기본으로 켜져 있고(워커당 유휴 연결 32개), 업스트림으로 HTTP/1.1을 기본 사용합니다. 하지만 배포판 패키지로 많이 쓰는 1.24·1.26 같은 이전 버전은 업스트림에 HTTP/1.0으로 요청하고 매번 연결을 닫습니다. 이전 버전이라면 아래 세 줄이 모두 있어야 재사용이 됩니다.
upstream backend_api {
    server 10.0.2.100:8080;
    server 10.0.2.101:8080;

    # 워커 프로세스당 보관할 유휴 연결 수
    keepalive 64;
}

server {
    location / {
        proxy_pass http://backend_api;

        # 1.29.7 이전 버전에서 필수
        proxy_http_version 1.1;
        proxy_set_header Connection "";
    }
}
proxy_set_header Connection ""이 빠지면 nginx가 Connection: close를 보내 백엔드가 연결을 닫습니다. nginx -v로 버전을 먼저 확인하고, 버전에 맞게 설정합니다. keepalive 값은 동시 연결 수의 상한이 아니라 쉬고 있는 연결을 몇 개 남겨 둘지입니다. 너무 크게 잡으면 백엔드의 동시 연결 한도를 유휴 연결이 차지할 수 있습니다.
애플리케이션 HTTP 클라이언트
마이크로서비스끼리 직접 호출하는 경우도 같습니다.
- Node.js 19 이상은 기본 전역 에이전트에 keep-alive가 켜져 있습니다. 하지만
new http.Agent()로 직접 만든 에이전트는keepAlive기본값이 여전히false입니다. - Go의
http.DefaultTransport는 keep-alive를 쓰지만 호스트당 유휴 연결 수(MaxIdleConnsPerHost)가 기본 2개입니다. 동시 요청이 많으면 남는 연결을 바로 닫아TIME_WAIT가 쌓입니다. - 요청마다 클라이언트 객체를 새로 만드는 코드는 풀이 매번 비어 있으니 재사용이 안 됩니다. 클라이언트는 한 번 만들어 공유합니다.
// 같은 호스트로 동시 요청이 많은 서비스라면 유휴 연결 수를 늘린다
tr := http.DefaultTransport.(*http.Transport).Clone()
tr.MaxIdleConns = 200
tr.MaxIdleConnsPerHost = 100
client := &http.Client{Transport: tr, Timeout: 5 * time.Second}
커널 설정은 보조 수단
재사용을 적용해도 짧은 연결이 많은 구조라면 커널 쪽도 조정합니다. 효과가 있는 것은 두 가지입니다.
# /etc/sysctl.d/99-ephemeral-ports.conf

# 나가는 연결에서 TIME_WAIT 소켓의 포트를 재사용 (0 끔, 1 켬, 2 루프백만)
net.ipv4.tcp_tw_reuse = 1

# 임시 포트 범위 확장 (기본 32768 60999)
net.ipv4.ip_local_port_range = 10240 65535sudo sysctl --system
sysctl net.ipv4.tcp_tw_reuse net.ipv4.ip_local_port_rangetcp_tw_reuse의 커널 기본값은 2로, 루프백 연결에서만 재사용합니다. 1로 바꾸면 다른 서버로 나가는 연결에서도, 프로토콜상 안전할 때 TIME_WAIT 소켓의 포트를 새 연결에 씁니다. 판단에 TCP 타임스탬프를 쓰므로 net.ipv4.tcp_timestamps가 켜져 있어야 합니다(기본값이 켜짐). 최근 커널에는 재사용 전 최소 대기 시간을 정하는 tcp_tw_reuse_delay(기본 1000ms)도 있습니다. 이 옵션은 연결을 거는 쪽(connect())에만 효과가 있고, 연결을 받는 서버의 TIME_WAIT에는 영향이 없습니다.
포트 범위를 낮은 번호부터 쓰게 하면 그 대역에서 리슨하는 서비스와 겹칠 수 있습니다. 예를 들어 kubelet의 10250, memcached의 11211 같은 포트입니다. 이런 포트는 임시 포트로 쓰이지 않게 예약해 둡니다.
# 임시 포트 선택에서 제외할 포트 (쉼표로 여러 개, 범위는 하이픈)
sudo sysctl -w net.ipv4.ip_local_reserved_ports=10250,11211
예전 글에서 자주 보이는 tcp_tw_recycle은 NAT 뒤 클라이언트들의 연결을 떨어뜨리는 문제 때문에 커널 4.12에서 삭제됐습니다. 지금 커널에는 없는 옵션이라 sysctl 파일에 남아 있으면 오류만 납니다.
적용 후 확인할 숫자
같은 부하에서 목적지별 상태 분포를 다시 봅니다. keepalive가 동작하면 ESTAB이 일정 수준으로 유지되고 TIME-WAIT가 크게 줄어듭니다.
watch -n 2 "ss -tan dst 10.0.2.100:8080 | awk 'NR>1 {print \$1}' | sort | uniq -c"

# TIME_WAIT 관련 커널 카운터 (누적값)
nstat -az TcpExtTWRecycled TcpExtTCPTimeWaitOverflowTcpExtTCPTimeWaitOverflow가 늘고 있다면 net.ipv4.tcp_max_tw_buckets 한도를 넘어 TIME_WAIT 없이 바로 정리되는 소켓이 생기고 있다는 뜻입니다. 이 값을 일부러 낮게 잡아 TIME_WAIT를 없애려는 설정도 보이는데, 늦게 도착한 패킷을 막는 장치를 끄는 것이라 권하지 않습니다.
헷갈리기 쉬운 부분
서버에 TIME_WAIT가 많다면 서버가 먼저 연결을 끊고 있는 것입니다. HTTP keep-alive 유휴 시간이 끝났을 때 서버가 먼저 닫는 구조가 흔한데, 클라이언트의 유휴 타임아웃을 서버보다 조금 짧게 두면 클라이언트 쪽에서 먼저 정리합니다. 이 경우에도 받는 쪽 포트는 하나(예: 443)라서 서버의 포트가 고갈되지는 않습니다. 메모리를 조금 쓸 뿐입니다.
컨테이너 환경이라면 ip_local_port_range, tcp_tw_reuse는 네트워크 네임스페이스마다 따로 적용됩니다. 호스트에서 바꿔도 컨테이너 안에는 반영되지 않으니, 프록시가 컨테이너로 돈다면 docker run --sysctl이나 Kubernetes의 securityContext.sysctls로 그 안에 설정합니다.
같은 서버의 다른 자원 고갈 사례는 Too many open files와 파일 디스크립터 한도에서 정리했습니다. 연결이 많으면 소켓마다 파일 디스크립터도 하나씩 쓰기 때문에 두 문제가 같이 나타나기도 합니다.