
kubectl get pod에서 STATUS가 CrashLoopBackOff로 보이면 컨테이너가 시작했다가 계속 종료되고 있다는 뜻입니다. 이 문구는 원인이 아니라 "재시작을 반복하는 중이며 다음 재시작까지 기다리는 상태"라는 결과 표시라서, 원인은 마지막 종료 기록에서 찾아야 합니다.
이 글은 종료 코드와 이전 로그로 원인을 가르는 순서와, 원인별로 무엇을 고치는지를 정리했습니다.
재시작 간격이 늘어나는 방식
kubelet은 실패한 컨테이너를 다시 시작하되, 간격을 10초에서 시작해 실패할 때마다 두 배로 늘려 최대 5분까지 벌립니다. 컨테이너가 10분 동안 문제없이 실행되면 간격이 처음으로 돌아갑니다. 그래서 수정 후에도 Pod가 바로 살아나지 않고 최대 5분 정도 기다릴 수 있습니다.
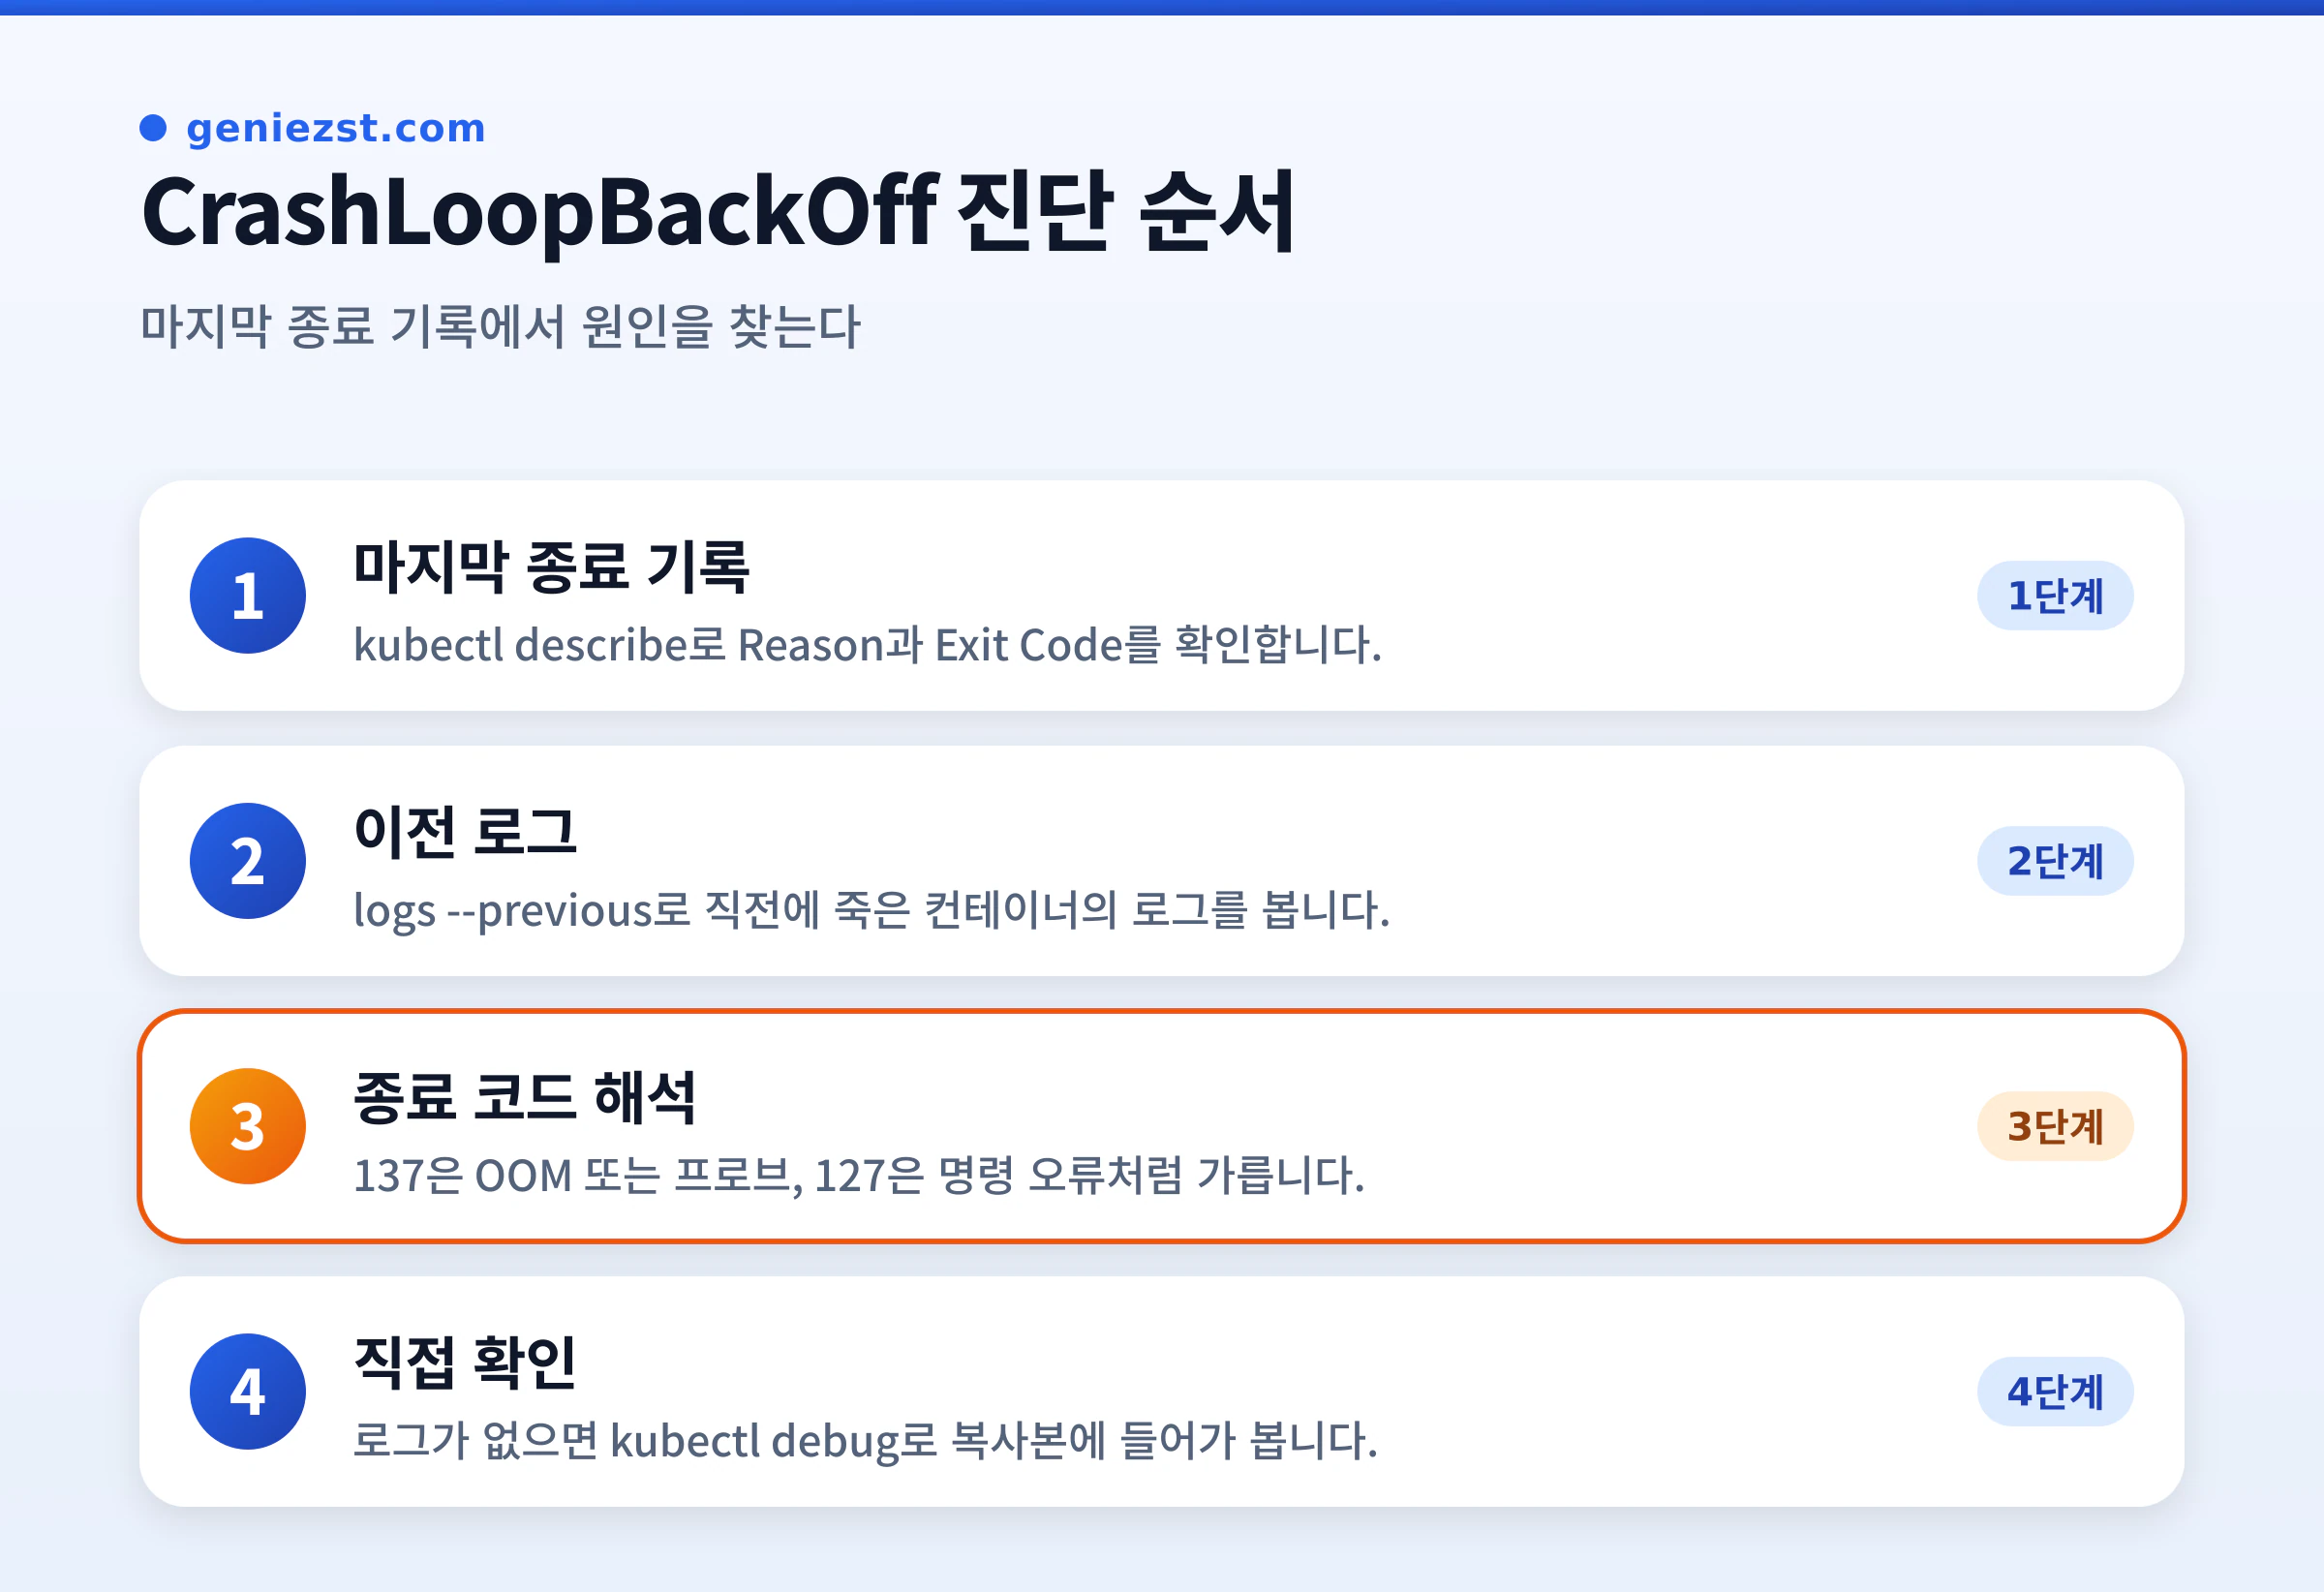
1단계 마지막 종료 기록 보기
kubectl describe pod <pod-name>출력에서 이 부분을 찾습니다.
Last State:     Terminated
  Reason:       <Error 또는 OOMKilled 또는 Completed>
  Exit Code:    <숫자>
Restart Count:  <횟수>
하단 Events에는 Back-off restarting failed container와 함께 프로브 실패나 이미지 문제 같은 단서가 남습니다. Pod 안에 컨테이너가 여러 개면 어느 컨테이너가 죽는지부터 확인하세요. 초기화 컨테이너가 죽으면 STATUS가 Init:CrashLoopBackOff로 표시됩니다.
2단계 이전 로그 보기
죽은 직후에는 현재 컨테이너가 막 다시 시작해서 로그가 비어 있습니다. 직전에 죽은 컨테이너의 로그를 봐야 합니다.
kubectl logs <pod-name> --previous
# 컨테이너가 여러 개일 때
kubectl logs <pod-name> -c <container-name> --previous
# 네임스페이스의 최근 이벤트
kubectl get events --sort-by=.lastTimestamp
3단계 종료 코드로 원인 가르기
| 종료 코드 | 의미 | 먼저 볼 곳 |
|---|---|---|
| 0 | 정상 종료 | 상시 실행해야 할 프로세스가 끝났는지, command와 args |
| 1 | 애플리케이션 오류 | --previous 로그의 스택 트레이스 |
| 126 | 실행 권한 없음 | 실행 파일 권한, 이미지의 ENTRYPOINT |
| 127 | 명령을 찾을 수 없음 | command 오타, 이미지에 없는 바이너리 |
| 137 | SIGKILL | Reason이 OOMKilled면 메모리 제한, 아니면 프로브 실패나 외부 종료 |
| 139 | SIGSEGV | 네이티브 라이브러리, 이미지 아키텍처 불일치 |
| 143 | SIGTERM | 종료 신호를 받고 끝난 경우, 롤아웃이나 노드 드레인 |
종료 코드는 128 + 시그널 번호 규칙을 따릅니다. 137은 128+9(SIGKILL), 143은 128+15(SIGTERM)입니다. 126과 127은 셸이 쓰는 관례 값입니다.
종료 코드 0인데 재시작된다
Deployment의 restartPolicy는 Always만 허용됩니다. 컨테이너가 작업을 마치고 정상 종료해도 다시 시작되고, 이것이 반복되면 CrashLoopBackOff로 보입니다. 일회성 작업이라면 Deployment가 아니라 Job이나 CronJob을 쓰세요. 웹 서버처럼 계속 떠 있어야 하는 프로세스라면 command나 args를 잘못 줘서 셸 명령만 실행하고 끝난 것은 아닌지 확인하세요.
137이고 OOMKilled인 경우
메모리 제한을 넘어 커널이 프로세스를 종료한 것입니다. 로그에 오류가 없는 채로 갑자기 끊기는 것이 특징입니다.
resources:
  requests:
    memory: "256Mi"
  limits:
    memory: "512Mi"
한도를 올리기 전에, 메모리 사용량이 정상 범위인지 kubectl top pod로 확인하세요. 누수가 있으면 한도를 올려도 시간이 지나 다시 죽습니다. 자바처럼 힙을 따로 지정하는 런타임은 컨테이너 한도보다 작게 맞춰야 합니다.
137이지만 OOMKilled가 아닌 경우
라이브니스 프로브가 실패해서 kubelet이 컨테이너를 종료했을 가능성이 큽니다. Events에 Liveness probe failed가 반복되는지 확인하세요.
startupProbe:
  httpGet:
    path: /healthz
    port: 8080
  periodSeconds: 5
  failureThreshold: 24   # 최대 120초까지 시작을 기다림
livenessProbe:
  httpGet:
    path: /healthz
    port: 8080
  periodSeconds: 10
  timeoutSeconds: 3
  failureThreshold: 3
시작이 느린 애플리케이션은 startupProbe를 두는 것이 initialDelaySeconds를 길게 잡는 것보다 안전합니다. 스타트업 프로브가 성공하기 전에는 라이브니스와 레디니스 프로브가 실행되지 않습니다.
설정을 못 찾는 경우
env의 configMapKeyRef나 secretKeyRef가 존재하지 않는 ConfigMap, Secret을 가리키면 컨테이너는 아예 시작하지 못하고 CreateContainerConfigError가 됩니다. 이 경우는 CrashLoopBackOff가 아닙니다. 반대로 값은 들어갔는데 내용이 잘못돼 애플리케이션이 시작 중에 종료하면 CrashLoopBackOff가 되고, 원인은 --previous 로그에 나옵니다.
kubectl get configmap <name> -o yaml
kubectl get secret <name> -o jsonpath='{.data}'
4단계 로그가 없을 때 직접 들어가 보기
로그가 한 줄도 없다면 시작 명령 자체가 문제일 수 있습니다. 컨테이너가 죽지 않도록 명령을 바꿔 복사본을 띄워 들어가 보세요.
kubectl debug -it <pod-name> --copy-to=<pod-name>-debug --container=<container-name> -- sh원본 Pod는 건드리지 않고, 같은 이미지와 설정으로 셸을 엽니다. 그 안에서 실행 파일이 있는지, 권한이 맞는지, 마운트된 설정 파일이 있는지 확인한 뒤 디버그용 Pod는 삭제하세요.
해결 후 확인
kubectl get pod에서 STATUS가Running이고RESTARTS가 더 늘지 않는지 확인했나요?kubectl logs <pod-name>에서 정상 시작 로그가 보이나요?- 메모리 한도를 올렸다면
kubectl top pod로 사용량 추이를 확인했나요? - 프로브를 바꿨다면 시작 시간보다 대기 시간이 충분한지 확인했나요?
종료 신호를 받았을 때 정리할 시간이 필요하면 terminationGracePeriodSeconds(기본 30초)를 늘리고, preStop 훅으로 종료 전 작업을 넣을 수 있습니다. preStop은 SIGTERM을 보내기 전에 실행됩니다.
자주 묻는 질문
ImagePullBackOff와 어떻게 다른가요?
ImagePullBackOff는 이미지를 가져오지 못해 컨테이너가 시작조차 못 한 상태입니다. CrashLoopBackOff는 이미지를 받아 시작까지 했지만 곧 종료하는 상태입니다. 원인을 보는 위치도 다릅니다. 전자는 describe의 Events에서, 후자는 이전 로그와 종료 코드에서 찾습니다.
그냥 기다리면 풀리나요?
원인이 일시적이면 풀립니다. 의존하는 DB가 아직 안 떠서 시작에 실패한 경우처럼요. 그런 경우도 애플리케이션이 재시도하도록 만드는 것이 근본 해결입니다.
Pod를 삭제하고 다시 만들면 되나요?
원인이 그대로면 다시 같은 상태가 됩니다. 삭제 전에 describe와 --previous 로그를 먼저 저장해 두세요. Pod가 사라지면 기록도 함께 사라집니다.