
Docker Compose로 웹 서버와 데이터베이스를 함께 띄웠는데 app 컨테이너만 시작하자마자 죽는 경우가 있습니다. 로그를 보면 db로 처음 연결하는 순간 Connection refused가 나고 프로세스가 종료되어 있습니다.
depends_on: [db]를 분명히 써 뒀는데도 이런 일이 생기는 이유는, 기본 depends_on이 db 컨테이너가 시작되는 것까지만 기다리기 때문입니다. db가 연결을 받을 준비가 되는 시점은 그보다 늦습니다. 개발 PC에서는 디스크가 빨라 가끔만 터지다가 CI나 느린 서버에서 자주 깨지는 식으로 나타납니다.
증상과 로그로 원인 좁히기
문제가 발생했을 때 가장 먼저 확인해야 하는 것은 애플리케이션 컨테이너의 로그와 종료 코드입니다. 의존하는 백엔드 서비스(예: PostgreSQL) 컨테이너가 생성되어 구동 중임에도 불구하고, 이를 참조하는 웹 서비스 컨테이너가 즉시 종료되는 전형적인 로그 패턴은 다음과 같습니다.
docker compose logs -t로 시각을 함께 보면 app은 이렇게 죽어 있습니다.
app-1  | 2026-10-31T08:00:01.304Z Error: connect ECONNREFUSED 172.18.0.2:5432
app-1 exited with code 1
같은 시각 db 컨테이너 로그는 아직 시작 중입니다.
db-1   | 2026-10-31 08:00:00.512 UTC [1] LOG:  starting PostgreSQL 18.0 on x86_64-pc-linux-musl
db-1   | 2026-10-31 08:00:02.874 UTC [1] LOG:  database system is ready to accept connections
app이 접속을 시도한 08:00:01경과 db의 ready to accept connections 시각(08:00:02)을 비교해 보세요. db 컨테이너는 이미 실행 중이었지만 연결을 받기 시작한 것은 1초 이상 뒤였고, app이 그 사이에 접속을 시도해 거부당한 것입니다. 로그의 시각과 버전은 예시이며 실제 값은 환경마다 다릅니다.
이름 해석이나 네트워크 문제로 오해하기 쉽지만 이 경우는 타이밍 문제입니다. db가 완전히 뜬 뒤에 docker compose restart app을 했을 때 정상 연결된다면 시작 순서가 원인입니다. 재시작해도 계속 실패한다면 Docker 컨테이너 내부 DNS 확인 실패와 외부 연결 문제 해결을 먼저 확인하세요.
depends_on과 컨테이너 생명주기의 내부 동작
depends_on을 쓰면 선행 서비스가 요청을 받을 준비가 될 때까지 Compose가 기다려 줄 거라고 생각하기 쉽습니다. 실제 기본 동작은 다릅니다.
컨테이너 상태는 **실행 중(Running)**과 **준비됨(Ready)**으로 나눠서 봐야 합니다.
- 실행 중: 컨테이너 네임스페이스와 격리 환경이 생성되고, 메인 프로세스(PID 1)가 시작된 상태를 의미합니다.
- 준비된: 메인 프로세스가 설정을 로드하고, 내부 소켓이나 포트를 바인딩하며, 백엔드 엔진이 정상적으로 작동하여 외부 요청을 처리할 수 있는 상태를 의미합니다.
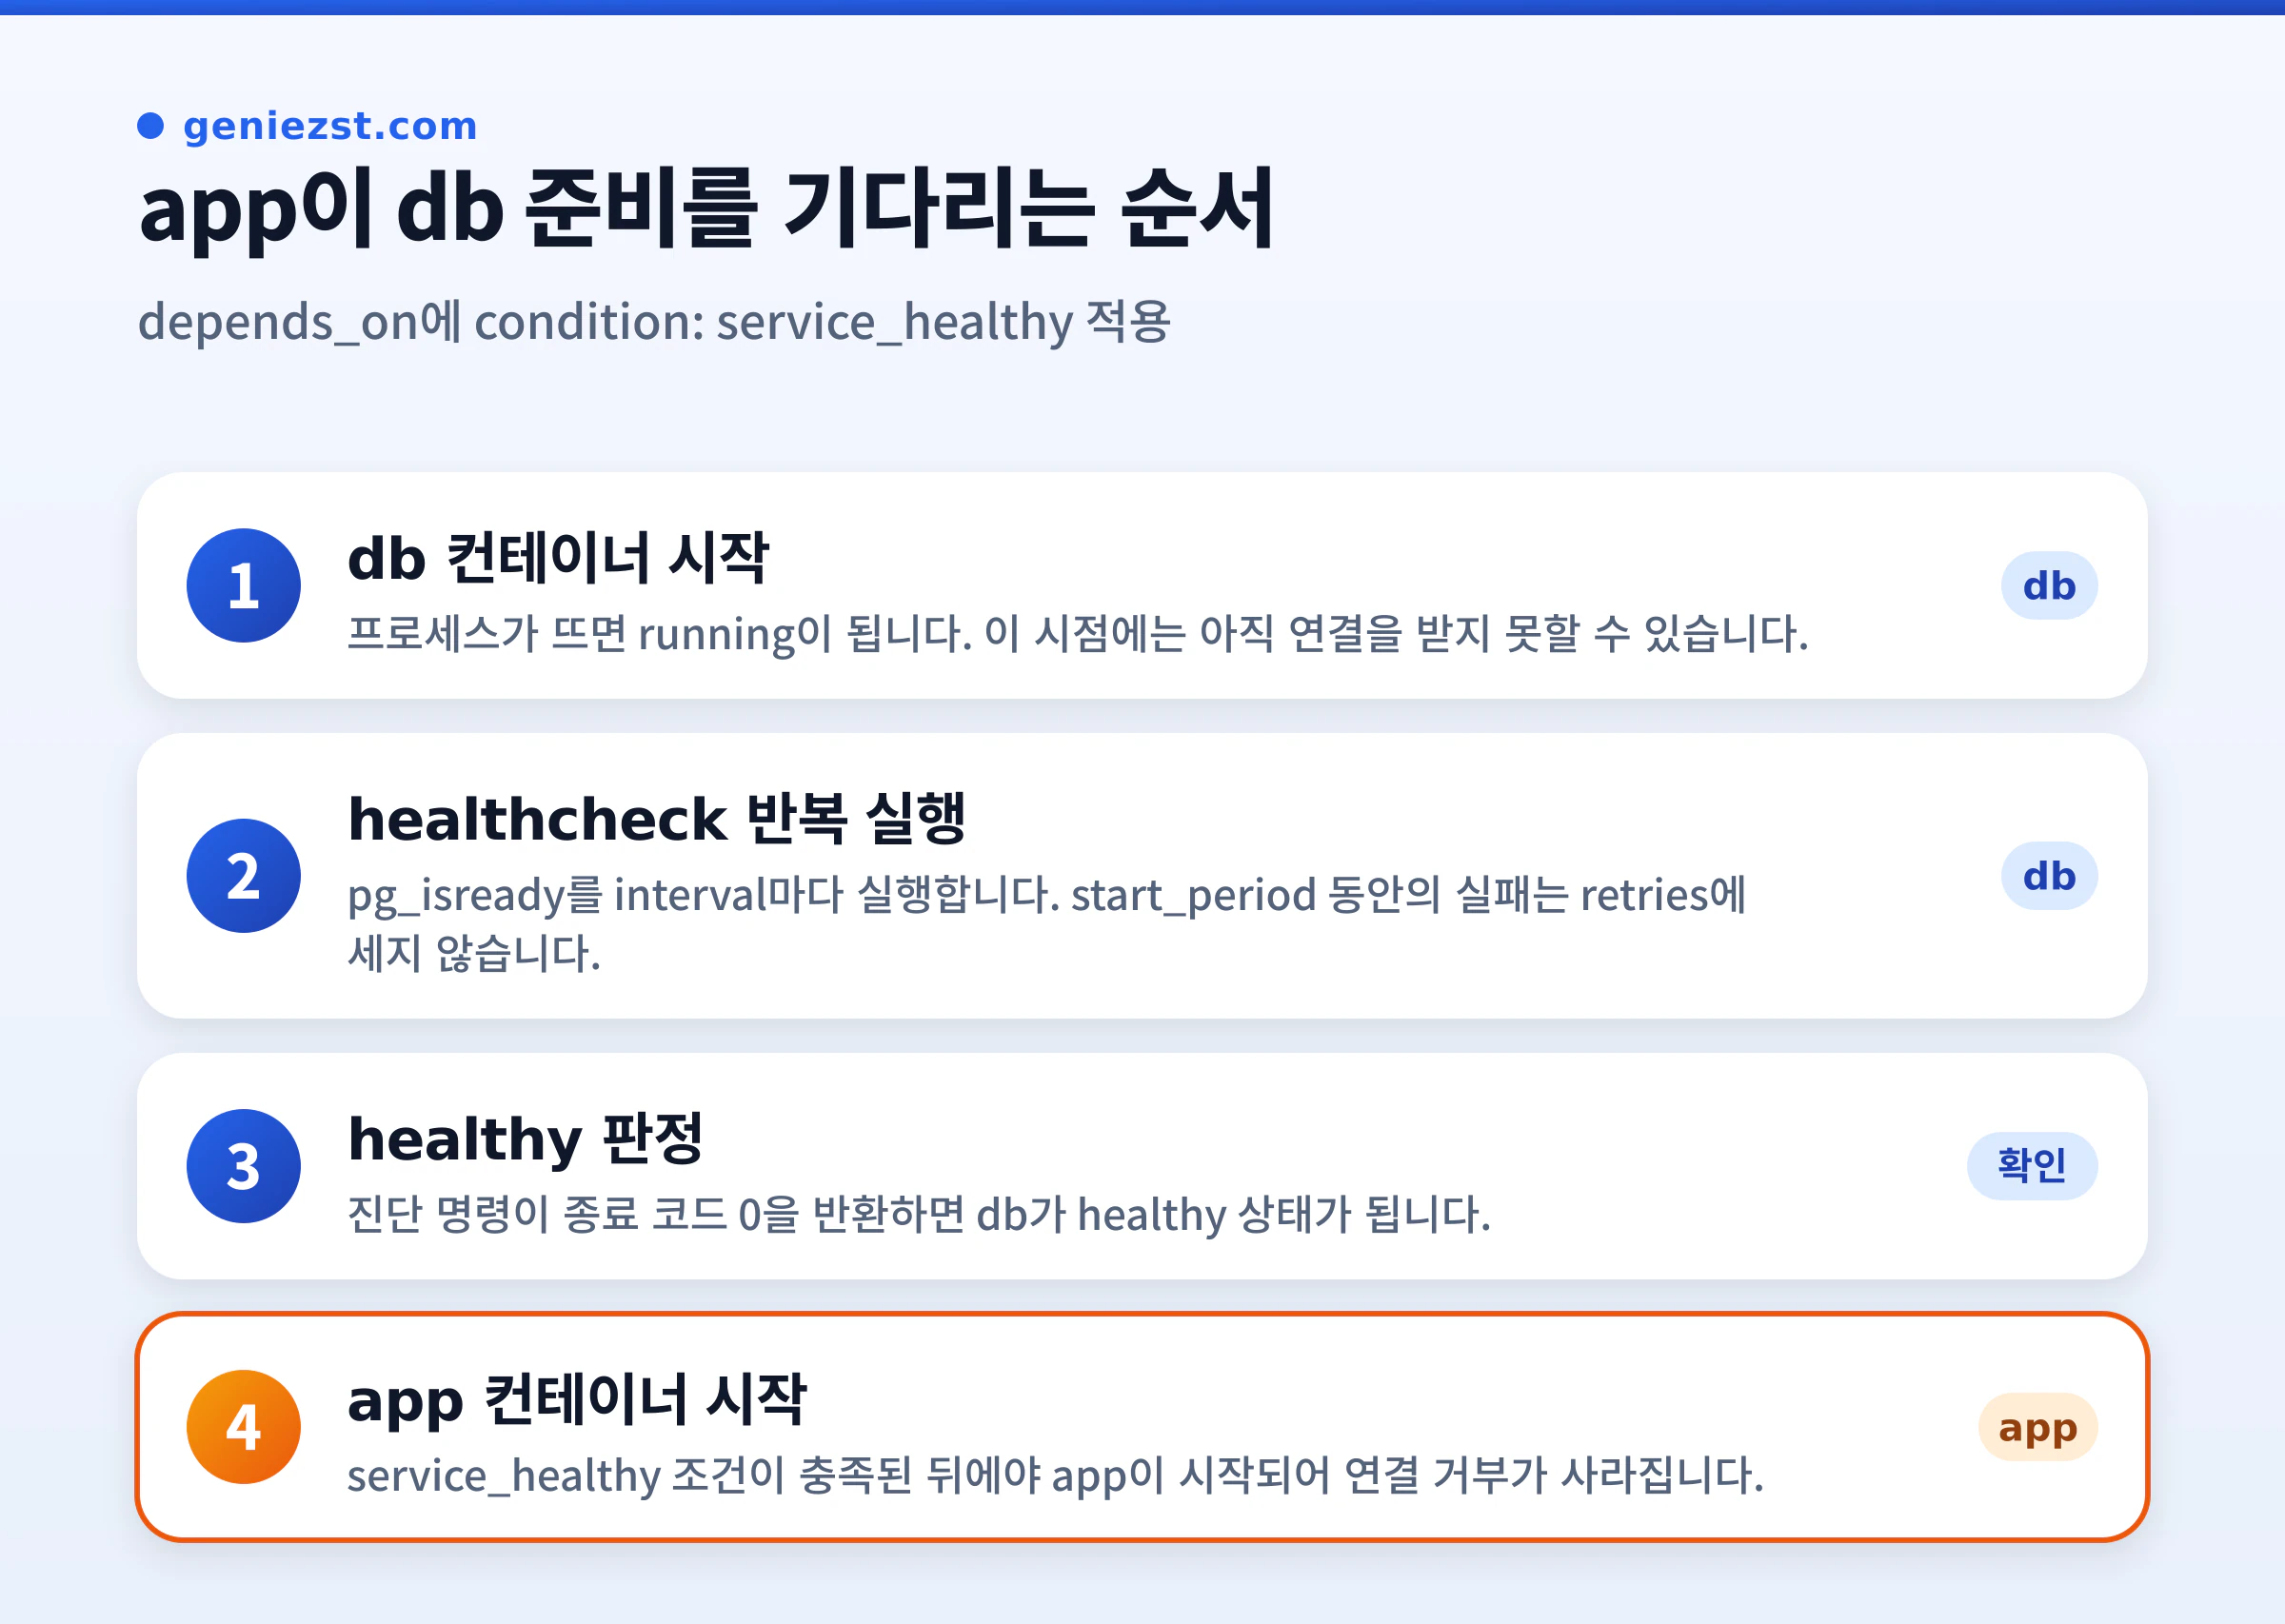
depends_on: [db]와 같은 짧은 형식(Short syntax)을 사용하면 Compose는 기본적으로 condition: service_started 조건을 적용합니다. 즉 db의 메인 프로세스가 시작되기만 하면 곧바로 app을 시작합니다. PostgreSQL이나 JVM 계열 서비스처럼 엔진이 뜨고 초기화를 마치는 데 수 초에서 수십 초 걸리는 서비스는 이 사이에 경쟁 상태(race condition)가 생깁니다.
| condition 설정값 | 동작 방식 | 적합한 사용처 |
|---|---|---|
service_started |
의존 대상 컨테이너의 프로세스가 시작되면 즉시 후속 서비스 실행 (기본값) |
포트 개방과 서비스 준비가 즉시 일어나는 경량 프로세스 |
service_healthy |
의존 대상 컨테이너의 healthcheck 명령이 성공(종료 코드 0)할 때까지 대기 |
DB, 메시지 브로커 등 초기화 시간이 필요한 백엔드 서비스 |
service_completed_successfully |
의존 대상 컨테이너가 정상적으로 작업 후 종료 코드 0으로 끝날 때까지 대기 | DB 마이그레이션, 초기 셋업 일회성 컨테이너 |
준비 상태까지 맞추려면 healthcheck로 db의 상태를 진단하고, app의 depends_on에 condition: service_healthy를 지정해야 합니다.
healthcheck가 없는 서비스에 condition: service_healthy를 걸면 docker compose up 단계에서 healthcheck가 없다는 오류로 중단됩니다. 오류 문구는 Compose 버전에 따라 다릅니다. 기다림의 대상이 되는 서비스에 반드시 healthcheck를 먼저 정의하세요.
healthcheck 파라미터 구조와 진단 메커니즘
healthcheck는 컨테이너 내부에서 주기적으로 특정 명령어를 실행하여 서비스의 건강 상태를 판별하는 기능입니다. 명령어의 실행 결과 반환되는 프로세스 종료 코드(Exit code)에 따라 컨테이너 상태가 결정됩니다.
- 종료 코드 0: 서비스가 정상 작동 중임을 나타내며,
healthy상태로 처리됩니다. - 종료 코드 0 이외의 값: 서비스에 문제가 있음을 나타내며,
unhealthy상태로 간주됩니다.
타이밍은 아래 다섯 가지 파라미터로 조절합니다.
test: 상태를 진단할 명령어를 정의합니다.CMD형식(셸 없이 바이너리를 직접 실행) 또는CMD-SHELL형식(/bin/sh -c를 거쳐 셸 문법으로 실행)으로 지정합니다.interval: 헬스 체크 명령을 실행하는 주기입니다. 기본값은 30초입니다.timeout: 진단 명령이 완료될 때까지 기다리는 최대 허용 시간입니다. 이 시간을 초과하면 실패로 처리됩니다. 기본값은 30초입니다.retries: 서비스가 최종적으로unhealthy로 낙인찍히기 전까지 허용되는 연속 실패 횟수입니다. 기본값은 3회입니다.start_period: 컨테이너가 시작된 직후 초기 기간 동안 헬스 체크 실패가retries횟수에 누적되지 않도록 하는 유예 기간을 제공합니다. 기본값은 0초입니다. 느리게 부팅되는 서비스가 섣부르게 비정상 판정을 받는 것을 방지합니다.
wait-for-it.sh 같은 스크립트는 TCP 포트가 열렸는지만 확인합니다. 포트가 열렸다고 해서 쿼리를 받을 준비가 끝난 것은 아니어서, 복구 중인 PostgreSQL은 포트가 열려 있어도 the database system is starting up으로 연결을 거부할 수 있습니다. pg_isready 같은 전용 도구로 점검하는 healthcheck가 더 정확합니다.
단계별 해결 가이드
문제를 해결하기 위해 compose.yaml 파일에서 종속성 서비스를 정의하고, 헬스 체크 명령을 추가하며, 후속 서비스가 이 상태를 기다리도록 재구성합니다.
- 백엔드 서비스(PostgreSQL 등)에 적절한
healthcheck진단 명령어와 타이밍 파라미터 정의 - 클라이언트 또는 웹 애플리케이션 서비스의
depends_on을 확장형 구문으로 변경하고condition: service_healthy지정 - 헬스 체크 대기 명령어를 통해 배포 순서 동기화 검증
PostgreSQL 데이터베이스 서비스에 healthcheck 추가
PostgreSQL 컨테이너에는 연결 준비 상태를 점검하는 전용 CLI 도구인 pg_isready가 내장되어 있습니다. 이를 활용하여 데이터베이스의 건강 상태를 점검합니다.
# compose.yaml
services:
  db:
    image: postgres:18-alpine
    environment:
      POSTGRES_DB: app_db
      POSTGRES_USER: postgres
      POSTGRES_PASSWORD: secure_password
    restart: unless-stopped
    healthcheck:
      # pg_isready 유틸리티로 사용자 및 데이터베이스 접근 가능 여부 점검
      test: ["CMD-SHELL", "pg_isready -U postgres -d app_db"]
      interval: 5s
      timeout: 5s
      retries: 5
      start_period: 10s
restart 정책(unless-stopped 또는 always)은 시스템 재부팅이나 예기치 않은 종료 시 컨테이너의 복구를 담당하는 별개의 설정이며, 기동 시점의 동기화는 healthcheck 블록이 전담합니다.
HTTP 기반 서비스 점검 및 웹 애플리케이션 종속성 설정
백엔드 API나 외부 HTTP 서비스의 경우 curl -f 명령어를 활용하는 것이 일반적입니다. -f 플래그는 서버가 HTTP 400 이상의 에러 코드를 반환할 때 비정상 종료 코드(0이 아닌 값)를 반환하므로 상태 진단에 매우 적합합니다.
아래 설정은 db의 service_healthy 상태를 기다린 후 실행되는 app 서비스의 예시입니다.
# compose.yaml
services:
  app:
    image: my-node-app:latest
    environment:
      DATABASE_URL: postgres://postgres:secure_password@db:5432/app_db
    restart: unless-stopped
    depends_on:
      db:
        # db 서비스가 헬스 체크를 성공적으로 통과할 때까지 app 기동 대기
        condition: service_healthy
    healthcheck:
      # 자체 HTTP 헬스 엔드포인트 검사
      test: ["CMD", "curl", "-f", "http://localhost:3000/health"]
      interval: 10s
      timeout: 3s
      retries: 3
      start_period: 5s
전체 서비스 구동 및 상태 대기
설정을 마쳤으면 서비스가 준비될 때까지 기다리면서 실행합니다.
# 서비스가 running 또는 healthy가 될 때까지 기다린 뒤 반환
docker compose up -d --wait--wait를 주면 up이 백그라운드로 실행되면서, 서비스가 running 상태가 되고 healthcheck가 있는 서비스는 healthy가 될 때까지 명령이 끝나지 않습니다. CI에서 다음 단계로 넘어가기 전 준비 확인용으로 쓰기 좋습니다.
적용 후 검증과 디버깅
헬스 체크 구성이 정상 작동하는지 확인하려면 Compose 프로세스의 실시간 상태와 컨테이너 내부 세부 정보를 조사해야 합니다.
실행 상태를 확인할 때는 다음 명령을 수행합니다.
# 서비스 컨테이너의 헬스 상태 요약 확인
docker compose ps
명령 실행 시 각 컨테이너의 상태 열에 (health: starting), (healthy), (unhealthy)와 같은 상태가 명확히 출력됩니다. db 컨테이너가 (healthy)로 바뀔 때까지 app 컨테이너가 기동되지 않고 대기 상태를 유지하는 것을 확인할 수 있습니다.
특정 컨테이너의 헬스 체크 실패 사유를 자세히 들여다보려면 docker inspect 명령을 사용하여 헬스 체크 로그 기록을 추출합니다.
# 헬스 체크 실행 결과 및 출력 로그 조회
docker inspect --format='{{json .State.Health}}' <컨테이너이름>
이 명령을 통해 진단 명령어가 실행된 시각, 반환된 종료 코드, 그리고 표준 출력/에러 메시지를 확인할 수 있으므로 스크립트 문법 오류나 권한 문제를 빠르게 짚어낼 수 있습니다.
- 기다림의 대상이 되는 서비스에
healthcheck블록이 있는지 확인 depends_on을 배열이 아닌 객체 형태로 쓰고condition: service_healthy를 지정했는지 확인test가 쓰는 도구(pg_isready,curl등)가 이미지 안에 설치되어 있는지 확인- 대용량 복원이나 워밍업 시간을 감안해
start_period를 넉넉히 잡았는지 확인
재발 방지를 위한 운영 팁과 주의점
헬스 체크가 엉뚱하게 실패하지 않도록 두 가지를 챙기세요.
경량 이미지 내 도구 부재 문제
alpine, slim, distroless 이미지에는 curl, wget, bash가 없는 경우가 많습니다. 이미지에 없는 도구를 test에 쓰면 executable file not found 오류가 나면서 계속 unhealthy로 남습니다.
데이터베이스는 이미지에 들어 있는 도구(PostgreSQL의 pg_isready, Redis의 redis-cli ping)를 쓰세요. 웹 앱은 빌드 단계에서 curl을 추가하거나, Node.js나 Python 같은 런타임으로 /health를 호출하는 한 줄 스크립트를 쓰면 됩니다.
start_period의 적정 설정
큰 덤프를 복원하거나 JVM 프레임워크가 뜰 때는 프로세스가 시작된 뒤에도 수십 초가 걸릴 수 있습니다. start_period가 짧으면 초기화 중에 실패가 쌓여 unhealthy로 바뀝니다. 평소 부팅 시간을 재 보고 그보다 넉넉하게 잡으세요.
애플리케이션의 재연결 로직
healthcheck는 시작할 때의 경쟁 상태를 줄여 줄 뿐입니다. db가 나중에 재시작되거나 네트워크가 끊기는 경우까지 막아 주지는 않습니다. 공식 문서도 애플리케이션이 연결 실패 시 재시도하도록 만드는 것을 권장하므로, 접속 코드에 재시도와 백오프를 함께 넣어 두세요.
자주 묻는 질문 (FAQ)
Q. depends_on: [db] 형태로 작성하면 헬스 체크를 기다리지 않나요?
네, 기다리지 않습니다. 배열 형태의 짧은 문법(depends_on: [db])은 condition: service_started와 같아서 db의 프로세스가 시작되면 바로 app을 시작합니다. healthcheck 통과를 기다리려면 객체 형태로 condition: service_healthy를 써야 합니다.
Q. condition: service_healthy를 선언했는데 서비스가 시작되지 않고 에러가 발생합니다.
기다림의 대상 서비스에 healthcheck가 없을 가능성이 가장 높습니다. 점검 기준이 없는 서비스에 service_healthy를 요구하면 Compose가 up을 중단합니다. 그다음으로는 healthcheck 자체가 계속 실패하는 경우를 의심하세요. 이때는 docker inspect의 .State.Health 로그에서 종료 코드와 출력 메시지를 확인합니다.
Q. restart 정책과 depends_on의 순서 제어는 어떻게 다른가요?
depends_on과 condition은 서비스를 처음 띄울 때의 순서와 대기 조건을 정합니다. restart: unless-stopped나 always는 컨테이너가 비정상 종료했거나 시스템이 재부팅됐을 때 Docker가 다시 띄우는 정책입니다. 역할이 다르므로 함께 씁니다. 실제로 restart: unless-stopped만 걸어 두면 app이 죽었다가 재시작하면서 우연히 연결에 성공하기도 하지만, 순서를 맞춘 것은 아니므로 healthcheck와 condition을 따로 설정해야 합니다.