NVMe SSD에서 작은 랜덤 쓰기나 fsync가 몰릴 때 지연 시간이 수십 배로 튀는 원인을 SLC 캐시 소진, 내부 GC, 전원 보호(PLP) 유무, 발열 스로틀링, APST 절전으로 나눠 확인하는 방법과 I/O 스케줄러·TRIM 설정을 정리했습니다.
데이터베이스를 NVMe SSD로 옮겼는데 평소에는 빠르다가 가끔 쓰기 지연이 수십 밀리초까지 튀는 경우가 있습니다. CPU와 메모리는 한가하고, O_DIRECT로 페이지 캐시를 우회해도 똑같이 재현됩니다. 이러면 애플리케이션보다 드라이브 자체나 커널 설정을 의심해야 합니다.
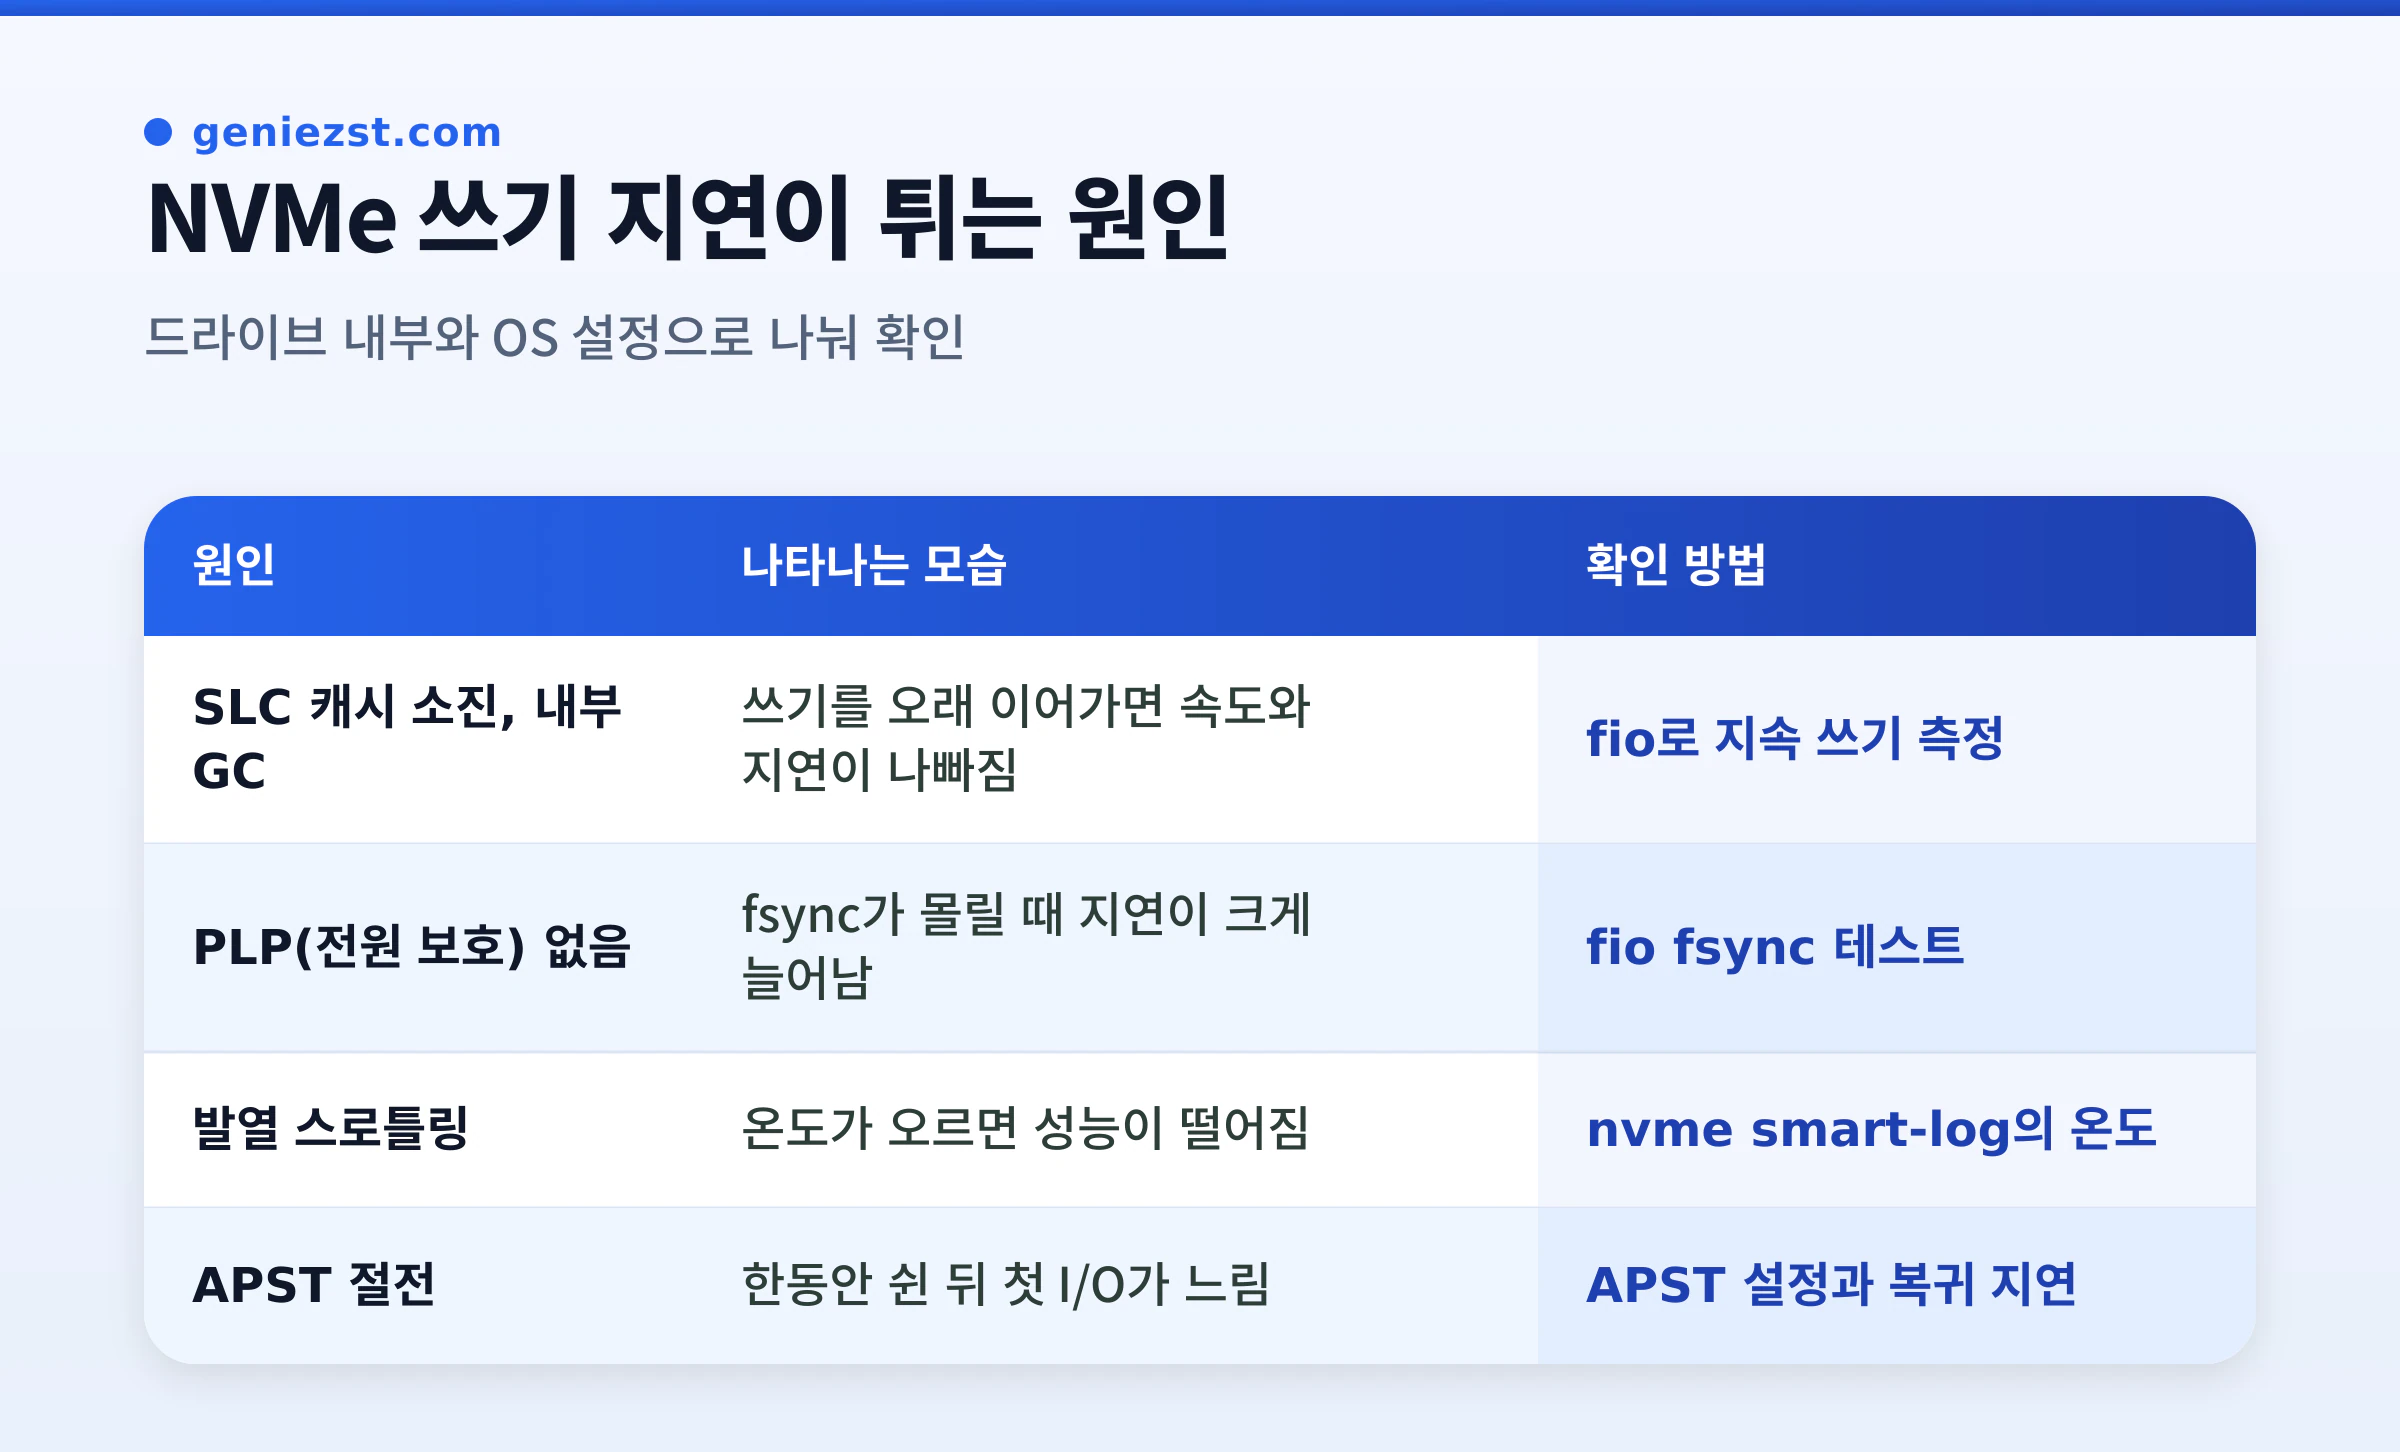
NVMe 지연이 튀는 원인은 몇 가지로 정리됩니다. 드라이브 내부 사정(SLC 캐시, GC, 전원 보호 유무, 발열), 그리고 OS 쪽 설정(절전, 스케줄러, TRIM)입니다. 어느 쪽인지는 측정 패턴으로 꽤 정확히 구분할 수 있습니다.
원인별 점검
지연을 재현하고 패턴 보기
평균값보다 분포가 중요합니다. fio로 지연 백분위를 같이 보면서, 시간이 지남에 따라 어떻게 변하는지 확인합니다. 아래 명령은 파일 위에서 테스트하니 기존 데이터를 지우지 않습니다.
# 1초 간격 확장 통계 (w_await: 쓰기 평균 대기, aqu-sz: 평균 큐 길이)
iostat -x 1 nvme0n1
결과를 볼 때 확인할 점은 세 가지입니다.
처음 몇십 초는 빠르다가 어느 순간 처리량이 뚝 떨어지고 그대로 유지된다: SLC 캐시 소진이나 GC 부하
쓰기량과 상관없이 주기적으로 튄다: 발열 스로틀링이나 백그라운드 작업
부하가 적을 때 오히려 첫 요청이 느리다: 절전 상태(APST) 복귀 지연
드라이브 내부 원인
SLC 캐시 소진과 GC
소비자용 TLC·QLC 드라이브는 빈 공간 일부를 SLC처럼 써서 쓰기를 빠르게 받습니다. 이 캐시가 차면 원래 속도로 떨어지는데, QLC 제품은 순차 쓰기 기준 수백 MB/s까지 내려가기도 합니다. 드라이브가 꽉 차 있을수록 캐시가 작아지고, 내부 GC가 유효 데이터를 옮기는 일도 많아져서 지연이 더 자주 튑니다.
사용률을 80% 아래로 유지하고, 지운 공간을 드라이브가 알 수 있도록 TRIM을 돌리는 게 기본 대응입니다. 지속 쓰기가 많은 서버라면 처음부터 여유 공간(오버프로비저닝)이 큰 데이터센터용 제품을 쓰는 게 맞습니다.
전원 손실 보호(PLP) 유무
데이터베이스 WAL처럼 fsync를 자주 부르는 워크로드에서 특히 중요합니다. 데이터센터용 SSD는 전원이 나가도 캐시 내용을 기록할 수 있는 축전기(PLP)가 있어서 플러시 요청을 바로 끝냅니다. 소비자용 SSD는 PLP가 없어서 플러시할 때마다 실제로 낸드에 쓸 때까지 기다리므로, fsync가 많을수록 지연이 크게 늘어납니다.
BASH
# 휘발성 쓰기 캐시 지원 여부 (vwc 값 1이면 휘발성 캐시 있음)sudo nvme id-ctrl /dev/nvme0 | grep -E "^vwc|^mn|^fr "# fsync 지연만 따로 측정
fio --name=fsync --filename=/data/fio.sync --size=1G \
--rw=write --bs=8k --fsync=1 --runtime=60 --time_based
fsync=1 테스트에서 IOPS가 수백 단위로 나오면 PLP 없는 드라이브일 가능성이 큽니다. 이 경우 설정으로는 크게 나아지지 않으니, WAL만이라도 PLP가 있는 드라이브에 두는 것을 검토합니다.
발열 스로틀링
NVMe 컨트롤러는 온도가 정해진 기준을 넘으면 스스로 속도를 낮춥니다. 방열판 없는 M.2 드라이브를 서버나 미니 PC에 넣었을 때 흔합니다.
BASH
# 온도, 경고 온도 초과 누적 시간 확인sudo nvme smart-log /dev/nvme0 \
| grep -Ei "temperature|warning|critical"
Warning Temperature Time이나 Critical Composite Temperature Time이 0이 아니면 스로틀링을 겪은 적이 있다는 뜻입니다. 같은 출력의 percentage_used(수명 사용률)와 media_errors도 함께 확인해 둡니다.
펌웨어 버전(fr)도 제조사 릴리스 노트와 비교해 봅니다. 특정 펌웨어에서 GC나 절전 관련 지연 버그가 고쳐진 사례가 적지 않습니다. 업데이트 전에는 백업을 먼저 해 둡니다.
OS 쪽 설정
APST 절전 복귀 지연
NVMe는 유휴 상태에서 자동으로 깊은 절전 상태로 들어갑니다(APST). 노트북에는 유용하지만, 일부 드라이브는 복귀에 수십 밀리초가 걸려 간헐적인 지연이나 심하면 장치가 사라지는 문제를 일으킵니다.
BASH
# 드라이브가 지원하는 전원 상태와 복귀 지연(exlat) 확인sudo nvme id-ctrl /dev/nvme0 | grep "^ps "# 현재 커널이 허용하는 최대 절전 지연 (마이크로초)cat /sys/module/nvme_core/parameters/default_ps_max_latency_us
서버라면 커널 부트 파라미터로 깊은 절전 상태를 막을 수 있습니다. 0이면 APST를 완전히 끕니다. 전력 소모가 늘어나니 노트북에서는 지연이 실제로 문제가 될 때만 씁니다.
BASH
# /etc/default/grub의 GRUB_CMDLINE_LINUX에 추가 후 grub 갱신
nvme_core.default_ps_max_latency_us=0
I/O 스케줄러
NVMe는 장치 안에 큐가 여러 개 있고 명령 재정렬도 직접 합니다. 그래서 대부분 배포판이 NVMe에 기본으로 none을 씁니다. 현재 값을 확인해 보고 다른 값으로 바뀌어 있다면 되돌립니다.
BASH
# 대괄호 안이 현재 스케줄러cat /sys/block/nvme0n1/queue/scheduler
# 즉시 변경 (재부팅하면 원래대로)echo none | sudotee /sys/block/nvme0n1/queue/scheduler
재부팅 후에도 유지하려면 udev 규칙을 씁니다. GRUB에 scsi_mod.use_blk_mq=1을 넣으라는 자료가 있는데, 이 옵션은 SCSI 장치용이고 커널 5.0부터는 아예 없어졌습니다. NVMe와는 관계가 없습니다.