Astro SSR 사이트를 Cloudflare Workers와 D1에 올릴 때 필요한 어댑터 설정, wrangler.jsonc 바인딩, cloudflare:workers로 env를 읽는 방법, 로컬과 원격 D1이 따로 노는 문제, 마이그레이션 순서를 정리했습니다. Astro 6부터 Astro.locals.runtime.env가 제거된 점도 다룹니다.
이 블로그는 Astro로 만들고 Cloudflare Workers에서 서버 렌더링으로 돌립니다. 글 데이터는 D1에, 이미지는 R2에 둡니다. 처음 붙일 때 참고한 글 대부분이 Astro.locals.runtime.env로 바인딩을 읽는 예제였는데, Astro 6부터는 이 방식이 제거됐습니다. 지금 버전(Astro 7, @astrojs/cloudflare 14)에서 실제로 동작하는 설정을 기준으로 정리했습니다.
예전 글에 자주 나오는 platformProxy: { enabled: true }는 더 이상 필요 없습니다. 지금 어댑터는 @cloudflare/vite-plugin 위에서 동작해서, astro dev가 처음부터 Cloudflare 런타임(workerd) 안에서 페이지를 렌더링합니다. 로컬에서도 D1과 R2 바인딩이 그대로 잡힙니다.
어댑터 기본값 중 하나는 알아 두는 게 좋습니다. Astro 세션 기능을 쓰면 어댑터가 SESSION이라는 KV 바인딩을 자동으로 만들려고 합니다. 세션을 안 쓰는데 배포 때 KV 네임스페이스가 생기는 게 싫다면 설정에 session: false처럼 꺼 두거나 쓰지 않는 상태로 둡니다.
npx wrangler d1 create blog
npx wrangler r2 bucket create blog

# 바인딩 타입을 worker-configuration.d.ts로 생성
npx wrangler types
wrangler types를 돌려 두면 env.DB가 D1Database 타입으로 잡혀서 prepare, bind 자동 완성이 됩니다. 바인딩을 바꿀 때마다 다시 실행합니다.
페이지에서 D1 읽기
Astro 6부터는 cloudflare:workers 모듈에서 env를 가져옵니다. 예전 방식인 Astro.locals.runtime.env에 접근하면 "Astro.locals.runtime.env has been removed in Astro v6"라는 오류가 납니다.
조건 값은 문자열로 이어 붙이지 말고 .bind()로 넘깁니다. 한 건만 필요하면 .first(), INSERT나 UPDATE는 .run()을 씁니다. 여러 쿼리를 한 번에 보내야 하면 env.DB.batch([...])로 묶으면 왕복이 한 번으로 줄고, 묶은 쿼리는 하나의 트랜잭션으로 처리됩니다.
같이 바뀐 항목도 있습니다. 요청의 cf 정보는 Astro.request.cf, waitUntil 같은 실행 컨텍스트는 Astro.locals.cfContext에서 읽습니다.
로컬 D1과 원격 D1은 별개
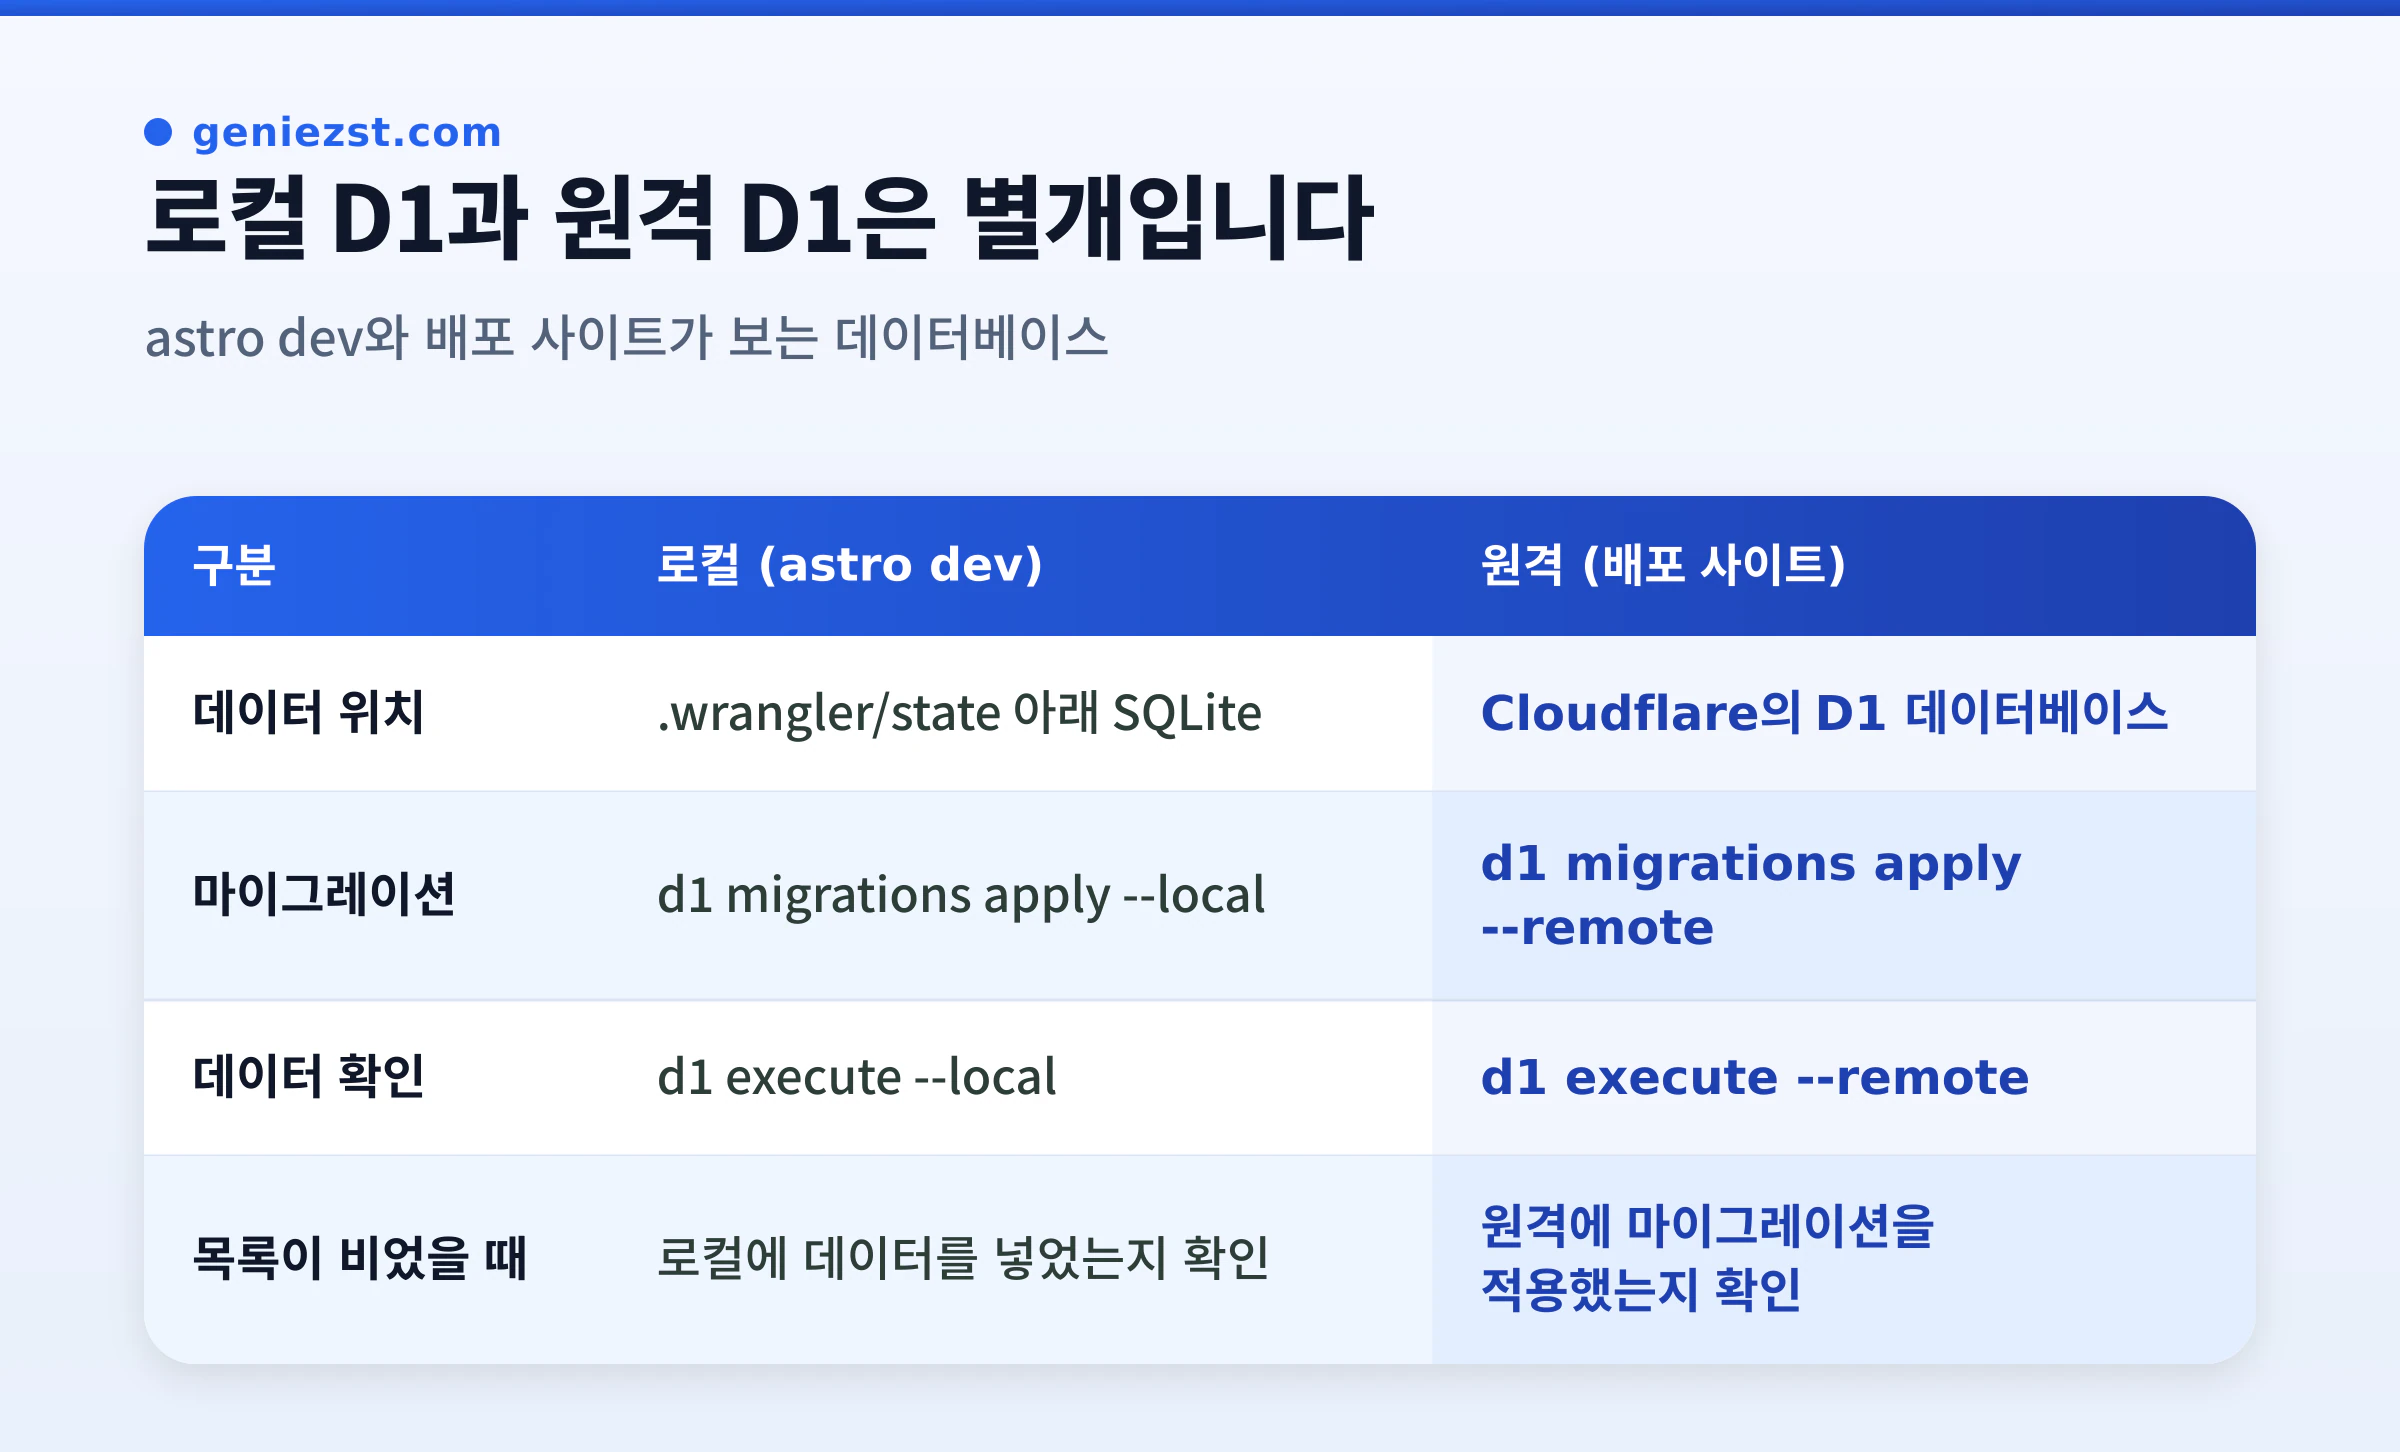
처음에 가장 헷갈린 부분입니다. astro dev가 쓰는 D1은 프로젝트의 .wrangler/state 아래에 있는 로컬 SQLite 파일이고, 배포된 사이트가 쓰는 D1과는 완전히 다른 데이터베이스입니다. 원격에 글을 넣어 놓고 로컬에서 목록이 비어 있다고 헤매거나, 그 반대로 착각하기 쉽습니다.
스키마는 마이그레이션 파일로 관리하고 양쪽에 각각 적용합니다.
BASH
# migrations/0001_initial_schema.sql 같은 파일 생성
npx wrangler d1 migrations create blog initial_schema
# 로컬 적용
npx wrangler d1 migrations apply blog --local# 원격 적용
npx wrangler d1 migrations apply blog --remote
# 원격 데이터 확인
npx wrangler d1 execute blog --remote --command"SELECT COUNT(*) FROM blog_posts"
D1은 적용한 마이그레이션을 d1_migrations 테이블에 기록해 두므로 같은 명령을 다시 실행해도 새 파일만 적용됩니다. 이미 적용한 파일을 고치면 다시 실행되지 않으니, 수정은 항상 새 마이그레이션 파일로 합니다.
로컬에서 원격 데이터를 그대로 보면서 개발하고 싶다면 바인딩에 "remote": true를 주는 방법이 있습니다. 다만 이 상태에서 로컬 코드가 쓰기를 하면 운영 데이터가 바뀌니 읽기 확인용으로만 쓰는 게 안전합니다.
배포
BASH
npx astro build
npx wrangler deploy
배포한 직후 목록이 비어 있다면 대부분 원격 D1에 마이그레이션을 적용하지 않았거나, 데이터를 로컬에만 넣은 경우입니다. 위의 d1 execute --remote로 행 수부터 확인합니다.
자주 받는 질문
Q. 빌드 중에 cloudflare:workers를 찾을 수 없다는 오류가 납니다.
cloudflare:workers는 Cloudflare 런타임 안에서만 존재하는 모듈입니다. 프리렌더하는 페이지에서 쓰거나, Node로 실행되는 별도 스크립트에서 가져오면 이 오류가 납니다. 서버 렌더링 페이지와 API 라우트 안에서만 쓰고, 공용 유틸에서 쓴다면 함수 안에서 동적으로 import() 하고 실패 시 null을 돌려주게 만들어 두면 빌드가 깨지지 않습니다.
Q. D1 응답이 느립니다.
D1은 기본적으로 데이터베이스가 만들어진 지역의 기본 인스턴스 하나에서 쿼리를 처리합니다. 사용자와 멀면 왕복 시간이 늘어납니다. 읽기 위주라면 읽기 복제(Read Replication)와 Sessions API를 쓰거나, 자주 바뀌지 않는 목록은 캐시해 두는 편이 낫습니다. 페이지 하나에서 쿼리를 여러 번 순서대로 보내고 있다면 batch로 묶는 것만으로도 꽤 줄어듭니다.
Q. 코드에 Astro.locals.runtime이 남아 있는데 바로 바꿔야 하나요?
Astro 6 이상으로 올렸다면 접근하는 순간 오류가 나므로 바꿔야 합니다. import { env } from 'cloudflare:workers'로 바꾸고, env.DB, env.BUCKET처럼 그대로 쓰면 됩니다.