LLM 토큰 스트리밍처럼 오래 열려 있는 gRPC 스트림이 NGINX Ingress나 Envoy를 지나며 60초, 5분, 15초 같은 기본 타임아웃에 걸려 끊기는 원인과 설정 방법, keepalive 핑 설정 시 주의점을 정리했습니다.
LLM 추론 서버를 gRPC 서버 스트리밍으로 붙이면 로컬에서는 잘 되다가, 프록시를 하나 거치는 순간 긴 응답만 골라서 끊기는 일이 생깁니다. 짧은 질문은 멀쩡하고, 대기열이 밀려 첫 토큰이 늦게 나오거나 답변이 길어질 때만 UNAVAILABLE이 납니다.
이런 경우 원인은 대부분 프록시의 기본 타임아웃입니다. 프록시마다 기준이 다르고 이름도 제각각이라 하나를 늘려도 다른 데서 또 끊깁니다. 경로에 있는 계층마다 어떤 타이머가 있는지 정리해 두면 원인을 훨씬 빨리 찾을 수 있습니다.
💡 확인 기준
2026년 10월 기준 ingress-nginx, Envoy, grpc-go 공식 문서를 기준으로 썼습니다. 로그와 설정의 호스트명, 서비스명은 설명용 예시입니다.
끊기는 지점
끊기는 지점을 숫자로 먼저 좁히기
클라이언트 오류 메시지만으로는 어느 계층이 끊었는지 알기 어렵습니다. 대신 끊기기까지 걸린 시간을 여러 번 재 보면 범인이 꽤 정확히 나옵니다. 아래 숫자는 각 프록시의 기본값입니다.
끊기는 시점
의심할 설정
응답 사이 공백이 60초 넘을 때
NGINX grpc_read_timeout 기본 60초
요청 시작 후 정확히 15초
Envoy 라우트 timeout 기본 15초
데이터가 5분 동안 없을 때
Envoy stream_idle_timeout 기본 5분
클라우드 LB 뒤에서 일정 시간 무응답
LB 유휴 타임아웃 (AWS ALB 기본 60초)
NGINX가 타임아웃으로 끊으면 클라이언트는 HTTP 504를 받고, gRPC 라이브러리는 이걸 UNAVAILABLE로 바꿔서 올려 줍니다. grpc-go 기준으로 대략 이런 모양입니다.
OUTPUT
rpc error: code = Unavailable desc = unexpected HTTP status code
received fromserver: 504 (Gateway Timeout)
NGINX 에러 로그에는 업스트림 읽기 타임아웃이 남습니다.
OUTPUT
upstream timed out (110: Connection timed out) while reading upstream,
request: "POST /inference.InferenceService/StreamPredict HTTP/2.0",
upstream: "grpc://10.42.0.5:8080"
DEADLINE_EXCEEDED는 성격이 다릅니다. 프록시가 아니라 클라이언트가 RPC에 건 데드라인이 지난 것이라, 클라이언트 코드의 context.WithTimeout이나 deadline 설정부터 봐야 합니다.
ingress-nginx 설정
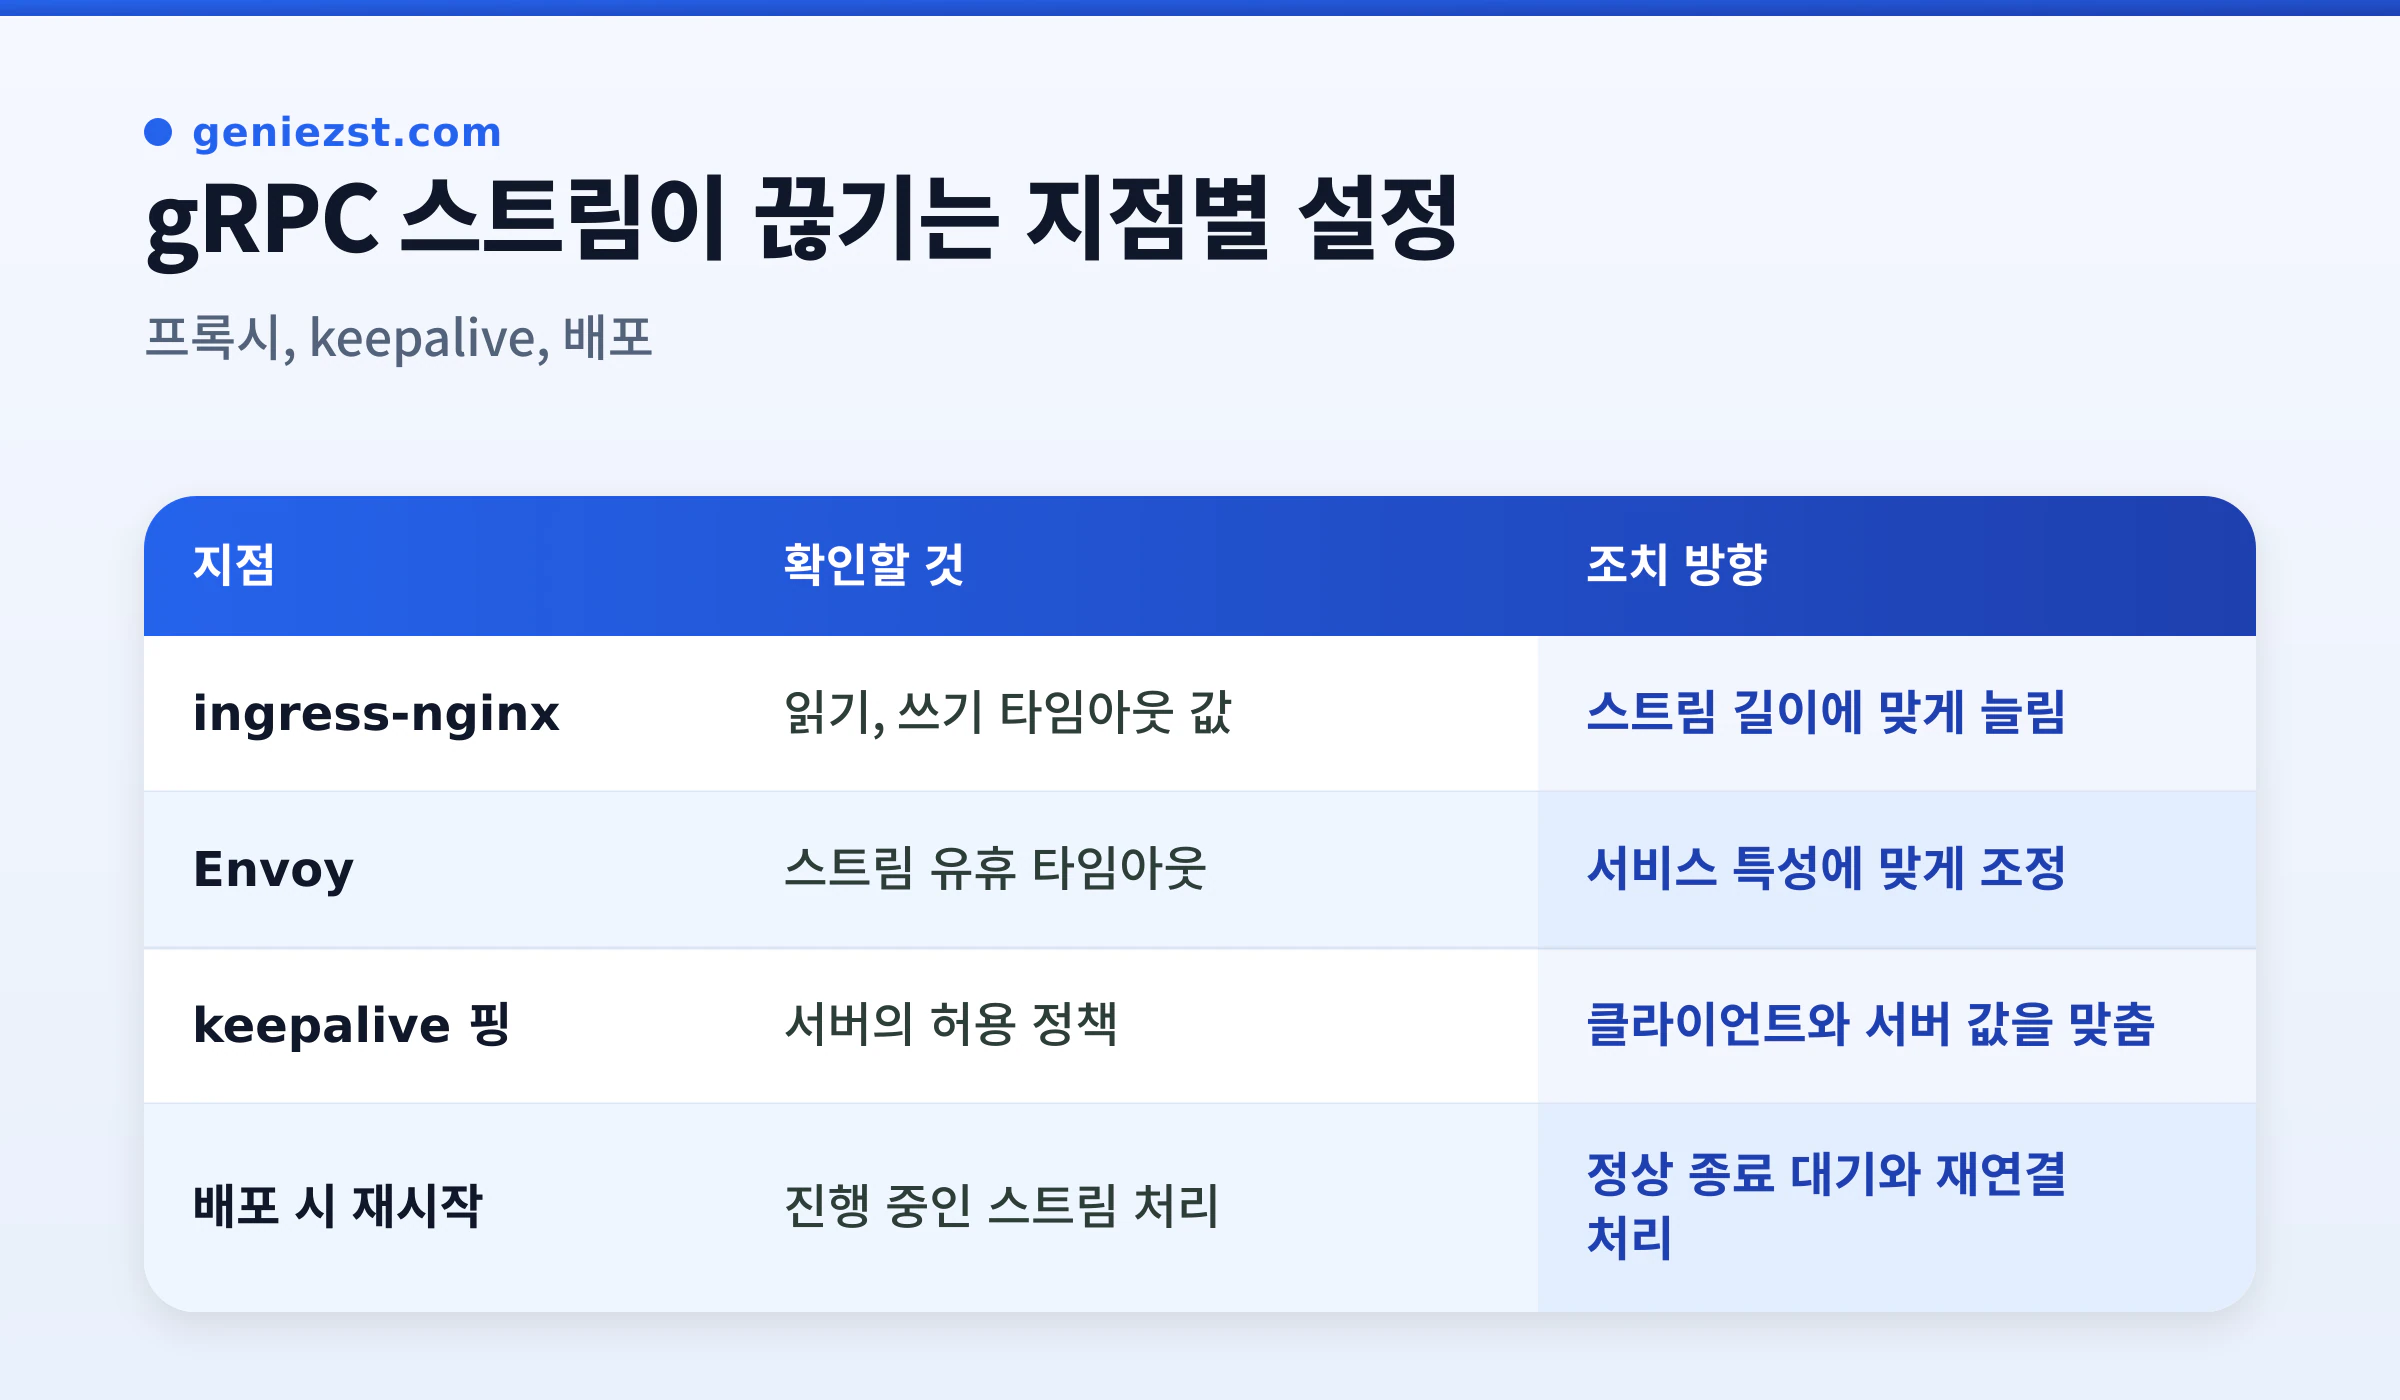
ingress-nginx는 백엔드를 gRPC로 지정하면 proxy_pass 대신 grpc_pass를 씁니다. 그래서 proxy-buffering 같은 proxy_* 계열 설정은 대부분 효과가 없습니다. 예외는 타임아웃으로, 공식 문서에 따르면 backend-protocol이 GRPC이면 proxy-read-timeout, proxy-send-timeout 값이 각각 grpc_read_timeout, grpc_send_timeout으로 들어갑니다.
apiVersion:networking.k8s.io/v1kind:Ingressmetadata:name:ai-inferencenamespace:ai-serviceannotations:# 백엔드를 gRPC로 지정 (grpc_pass 사용)nginx.ingress.kubernetes.io/backend-protocol:"GRPC"# 아래 두 값이 grpc_read_timeout / grpc_send_timeout으로 들어감 (초 단위)nginx.ingress.kubernetes.io/proxy-read-timeout:"600"nginx.ingress.kubernetes.io/proxy-send-timeout:"600"spec:ingressClassName:nginxtls:-hosts: ["ai.example.com"]
secretName:ai-example-tlsrules:-host:ai.example.comhttp:paths:-path:/pathType:Prefixbackend:service:name:ai-inferenceport:number:8080
client_body_timeout은 컨트롤러 전체 설정인 ConfigMap에서 바꿉니다. Helm으로 설치했다면 ConfigMap 이름은 보통 ingress-nginx-controller입니다.
YAML
apiVersion:v1kind:ConfigMapmetadata:name:ingress-nginx-controllernamespace:ingress-nginxdata:# 클라이언트 스트리밍에서 요청 본문 사이 공백 허용 시간 (초)client-body-timeout:"600"
타임아웃을 한 시간 이상으로 크게 잡는 것보다는, 서버가 일정 간격으로 하트비트 메시지를 흘려 보내도록 만드는 쪽이 낫습니다. 타임아웃은 "메시지 사이의 공백" 기준이라, 30초마다 빈 메시지라도 오가면 긴 스트림도 끊기지 않습니다.
⚠️ ingress-nginx 지원 종료
Kubernetes 커뮤니티의 ingress-nginx는 2026년 3월로 유지보수가 끝났고 이후 보안 패치도 나오지 않습니다. 새로 구성한다면 Gateway API 구현체나 다른 Ingress 컨트롤러를 검토하세요. F5가 만드는 NGINX Ingress Controller는 별개 프로젝트라 설정 키 이름이 다릅니다.
Envoy 설정
Envoy는 기본값 때문에 걸리는 지점이 두 군데 있습니다. 라우트 timeout은 응답 전체를 기다리는 시간인데 기본 15초라 스트리밍에서는 거의 반드시 걸립니다. HTTP 연결 관리자의 stream_idle_timeout은 기본 5분이라, 그 시간 동안 데이터가 없으면 스트림을 닫습니다.
YAML
# HttpConnectionManager 일부stream_idle_timeout:600s# 기본 5분, 스트림 무응답 허용 시간route_config:virtual_hosts:-name:inferencedomains: ["*"]
routes:-match: { prefix:"/" }
route:cluster:ai_inferencetimeout:0s# 응답 전체 시간 제한 해제 (기본 15초)idle_timeout:600s# 이 라우트만 무응답 허용 시간 덮어쓰기
업스트림을 HTTP/2로 연결하는 설정은 예전처럼 클러스터에 http2_protocol_options를 바로 쓰는 방식이 폐기 예정이 되었습니다. 지금은 typed_extension_protocol_options로 지정합니다. 연결 단위 HTTP/2 핑도 여기서 켭니다.
YAML
clusters:-name:ai_inferencetype:STRICT_DNSload_assignment:cluster_name:ai_inferenceendpoints:-lb_endpoints:-endpoint:address:socket_address:address:ai-inference.ai-service.svc.cluster.localport_value:8080typed_extension_protocol_options:envoy.extensions.upstreams.http.v3.HttpProtocolOptions:"@type":type.googleapis.com/envoy.extensions.upstreams.http.v3.HttpProtocolOptionsexplicit_http_config:http2_protocol_options:connection_keepalive:interval:60s# 업스트림 연결에 HTTP/2 PING 전송 주기timeout:20s# PING 응답 대기 시간
Envoy의 HTTP/2 PING은 기본으로 꺼져 있습니다. 중간에 방화벽이나 NAT가 있어 유휴 연결이 조용히 사라지는 환경에서만 켜면 됩니다.
keepalive 핑은 서버 정책과 맞춰야 한다
연결이 끊긴다고 클라이언트 keepalive를 짧게 잡는 경우가 많은데, 이건 오히려 새 문제를 만듭니다. gRPC 서버는 너무 자주 오는 핑을 공격으로 보고 연결을 끊습니다. grpc-go 서버는 기본적으로 5분보다 짧은 간격의 핑을 허용하지 않고, 위반하면 GOAWAY에 too_many_pings를 실어 보냅니다.
GO
// 서버: 클라이언트가 30초 간격으로 핑을 보내도 허용
grpc.NewServer(
    grpc.KeepaliveEnforcementPolicy(keepalive.EnforcementPolicy{
        MinTime:             30 * time.Second,
        PermitWithoutStream: true,
    }),
)

// 클라이언트: 서버 허용치보다 짧지 않게 설정
grpc.NewClient(target,
    grpc.WithKeepaliveParams(keepalive.ClientParameters{
        Time:                30 * time.Second,
        Timeout:             10 * time.Second,
        PermitWithoutStream: true,
    }),
)
클라이언트 Time을 서버 MinTime보다 짧게 잡지 않는 것이 핵심입니다. 프록시를 사이에 두면 클라이언트 핑은 프록시까지만 가고 백엔드 서버에는 닿지 않는다는 점도 기억해 두세요. 백엔드 쪽 연결은 프록시 설정(Envoy의 connection_keepalive 등)이 책임집니다.
배포할 때 스트림이 끊기는 문제
타임아웃을 다 맞춰도 롤링 업데이트 때마다 진행 중인 스트림이 끊긴다면, 파드 종료 순서를 봐야 합니다. 파드가 SIGTERM을 받는 시점과 엔드포인트에서 빠지는 시점이 엇갈려서 생기는 문제입니다.
YAML
spec:# 진행 중인 생성이 끝날 시간만큼 넉넉히 (기본 30초)terminationGracePeriodSeconds:300containers:-name:inferencelifecycle:preStop:# 엔드포인트에서 빠질 때까지 새 요청 유입을 잠깐 기다림sleep:seconds:10
preStop의 sleep 액션은 Kubernetes 1.30부터 기본으로 쓸 수 있습니다. 그보다 오래된 클러스터라면 exec로 sleep 명령을 실행하면 됩니다. 서버 코드는 SIGTERM을 받으면 GracefulStop()을 호출해 새 스트림은 거절하고 진행 중인 스트림은 끝까지 보내게 합니다.
자주 받는 질문
Q. 호스트의 net.ipv4.tcp_keepalive_time을 줄이면 해결되나요?
대부분 효과가 없습니다. 이 값은 소켓에 SO_KEEPALIVE를 켠 프로그램에만 적용되고, 쿠버네티스 파드는 노드와 다른 네트워크 네임스페이스를 쓰기 때문에 노드에서 바꾼 값이 파드에 들어가지 않습니다. 애초에 위의 타임아웃들은 TCP가 아니라 HTTP/2 스트림 단위로 동작하므로, 프록시와 gRPC 설정을 고치는 게 맞습니다.
Q. http2-max-concurrent-streams를 올려야 하나요?
ingress-nginx의 기본값은 연결당 128개입니다. 클라이언트가 연결 하나로 수백 개 스트림을 동시에 여는 구조가 아니라면 건드릴 일이 거의 없습니다. 반대로 서버 쪽 동시 스트림 제한에 걸리면 끊기는 게 아니라 새 RPC가 대기하므로 증상이 다릅니다.
Q. 몇 시간 잘 되다가 한꺼번에 재연결이 일어납니다.
NGINX는 연결 하나가 일정 개수의 요청을 처리하거나(keep-alive-requests) 일정 시간이 지나면 GOAWAY를 보내고 연결을 정리합니다. 진행 중인 스트림은 끝까지 보내지만, 클라이언트가 GOAWAY를 받은 연결에 새 RPC를 보내다 실패하는 구현이라면 오류로 보입니다. 클라이언트에 재시도 정책을 두고, 공식 gRPC 라이브러리를 최신 버전으로 유지하는 게 가장 간단한 대응입니다.